UCM Store 的 Pipeline 架构:把存储拆成一条可插拔流水线
UCM(Unified Cache Manager,统一缓存管理器)是华为 ModelEngine 团队开源的 LLM KV Cache 存储系统,它要解决的问题很具体:KV Cache 从 GPU 显存上被卸载(offload)之后,落到主机内存、本地 SSD 还是远端存储,怎么在保证“取回来比重新算一遍便宜”的前提下,让这套存储既能跑得快,又能随时换掉其中一块。
这篇只回答一个问题:UCM Store 凭什么把一次 KV Cache 的落盘与回读做成一条“流水线”,而不是一个大而全的存储单体? 答案不在某个单点优化上,而在它把一个完整的存储动作拆成了若干层——查缓存、压缩、读写磁盘、调度 IO ——每一层只干一件事,层与层之间靠一份很小的接口契约接起来,于是“快”和“可改”这两个通常互相拉扯的目标被同时拿到了。
材料来源需要先说清楚:本文只解读官方设计文档《Store Architecture》。这份文档目前在正式站点 ucm.readthedocs.io 的 en/latest 下还读不到(截至 2026-10-23,/design-doc/store_architecture.html 返回 404,正式站的设计文档挂在 developer-guide/design-docs/ 这套另一套路径下),能访问的是 Read the Docs 为 PR 954 生成的预览构建 ucm--954.org.readthedocs.build/en/954/。预览构建会随 PR 生命周期消失,所以文中凡是官方口径的数字和结论,我都标了出处章节;这些性能数字全部是文档自述,我没有在本地复现,涉及测试场景的还会额外标注。
读者能拿走的东西有三样:一张六层堆栈的全景图;几个可以直接搬到别处的架构套路(拦截式分层、压缩层的位置、切片 + 失败隔离的异步任务、定长类型作为性能基础设施);以及一份“哪些说法是设计意图、哪些是实测数字”的分级清单——后者在读这类设计文档时比结论本身更有用。
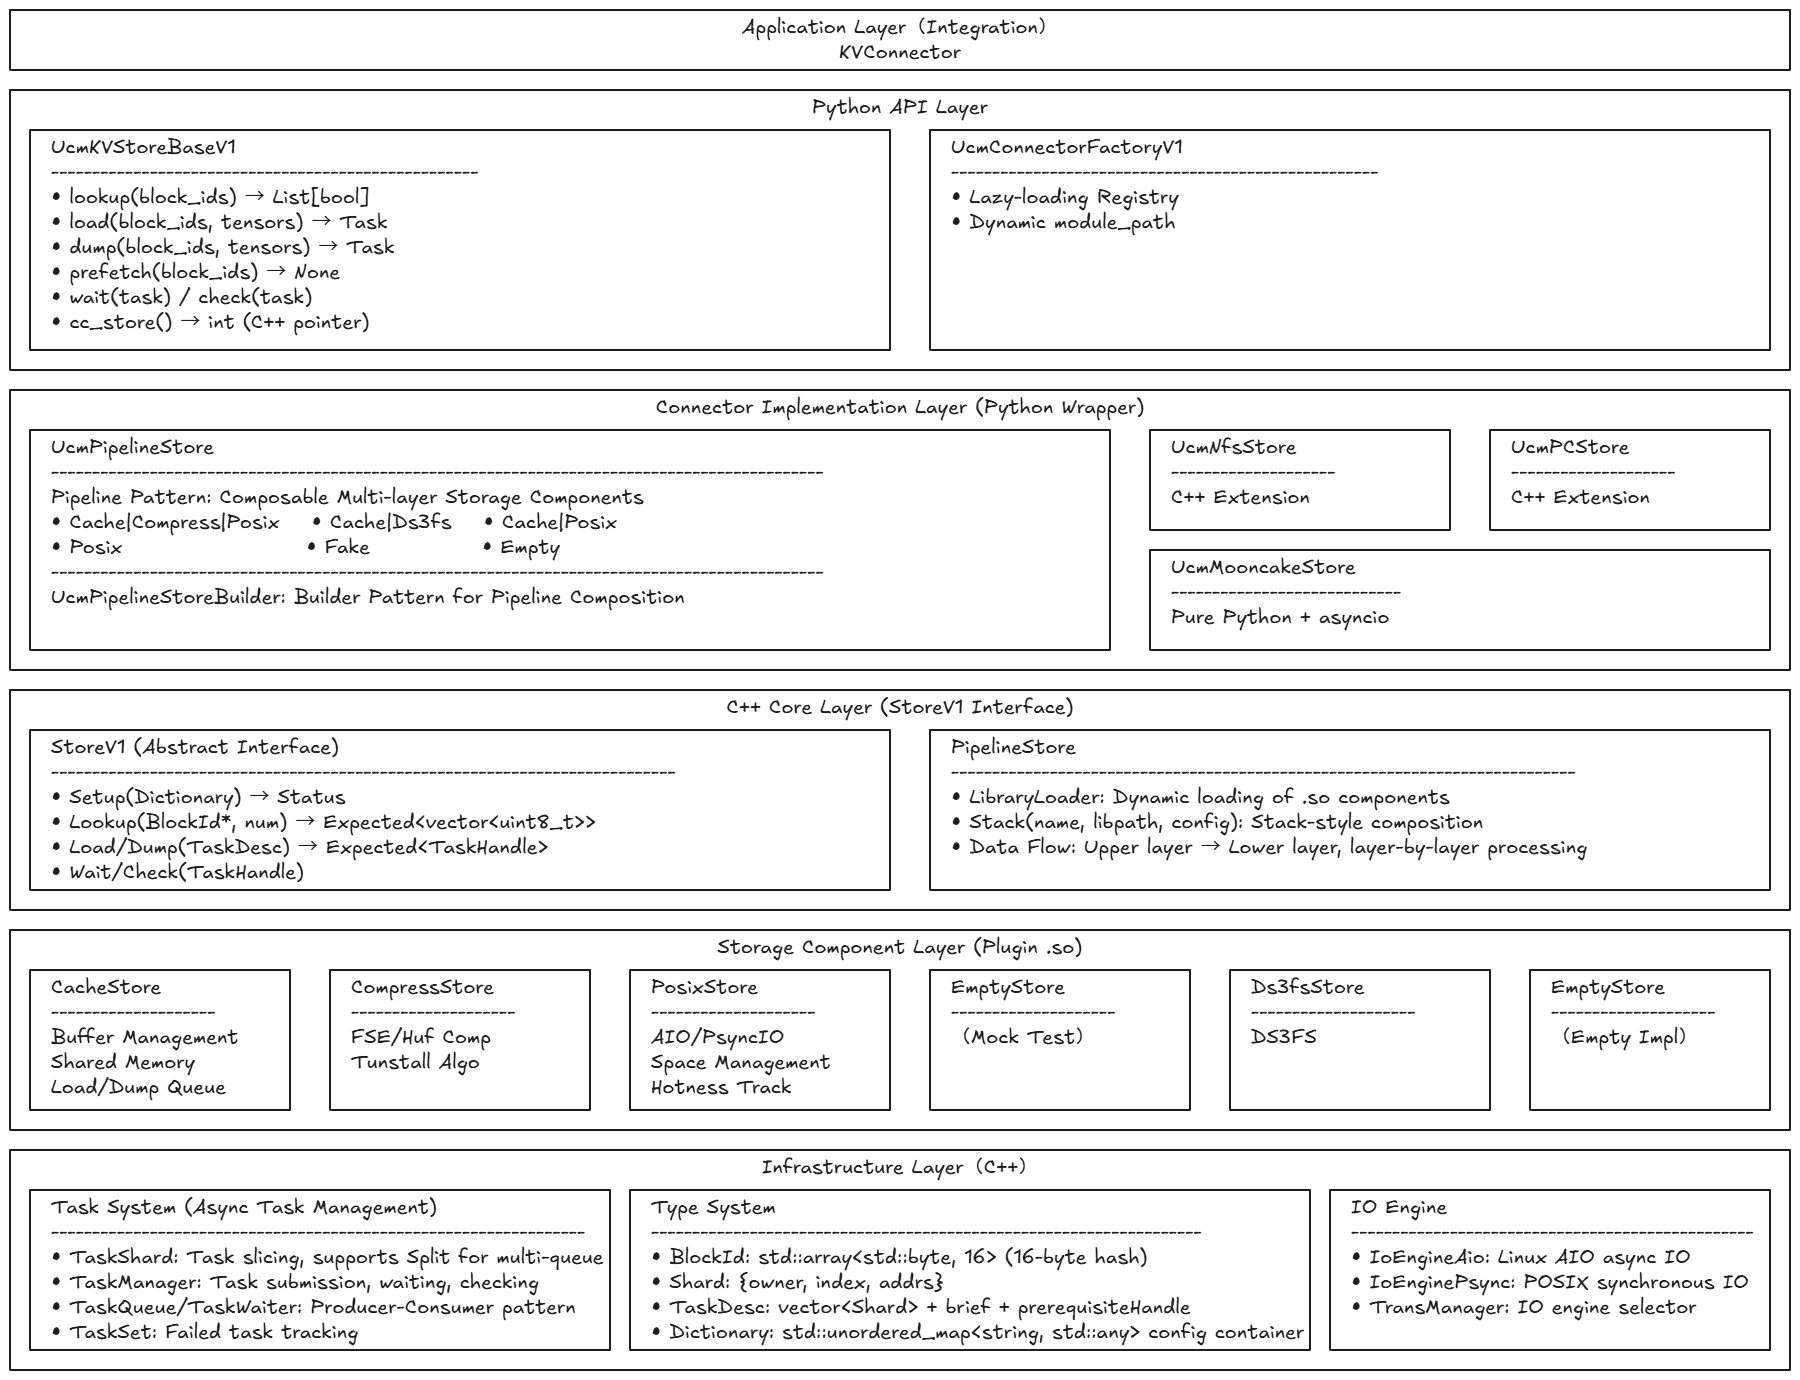
原图 1800×1380 像素,正文栏较窄会被等比缩小,点击图片可看原尺寸。下文第 1 节用 ASCII 重画了主干,对着看更省力。
1. 全景:六层堆栈与一条自顶向下的数据流
从上往下读这张图,六层职责划分得很干净,没有一层是“顺便也管一点”:
| 层 | 代表组件 | 只负责什么 |
|---|---|---|
| 应用/集成层 | KVConnector |
对接推理引擎(vLLM 等),把“要不要卸载/回读”的决策翻译成调用 |
| Python API 层 | UcmKVStoreBaseV1、UcmConnectorFactoryV1 |
对外暴露 Python 侧接口;Connector 的懒加载注册表与动态 module_path |
| Connector 实现层 | UcmPipelineStore + UcmPipelineStoreBuilder;旁挂 UcmNfsStore、UcmPcStore、UcmMooncakeStore |
把“用户想要的组合”翻译成一条实际的 Pipeline,或直接落地成别的存储形态 |
| C++ Core 层 | StoreV1(抽象接口)、PipelineStore |
定义组件契约;LibraryLoader 动态加载 .so,Stack 做栈式组装 |
| 存储组件层(插件 .so) | CacheStore、CompressStore、PosixStore、Ds3fsStore、EmptyStore |
每一层一个 .so,各自实现 Setup/Lookup/Load/Dump/Wait |
| 基础设施层 | 任务系统(TaskShard/TaskManager/TaskQueue/TaskSet)、类型系统(BlockId/Shard/TaskDesc/Dictionary)、IO 引擎(IoEngineAio/IoEnginePsync/TransManager) |
被上面所有层共用,不持有业务语义 |
注意 C++ Core 层那一格里只有两个东西:一个纯虚的 StoreV1,和一个只做“加载 + 组装 + 逐层下传”的 PipelineStore。这是整篇文档最关键的架构决策——核心层不含任何存储策略。策略全在下游的 .so 里,核心层只保证“数据从上层流到下层”这件事本身成立。所以后面无论是换压缩算法、换 IO 引擎、还是新增一种组合,都不需要改动核心层一行代码。
一条典型的 Load 请求在这条栈里的走向是这样(| 表示组合,文档里预置的组合名就是这个写法:Cache|Compress|Posix):
调用方 (vLLM / KVConnector) │ lookup / load / dump / wait ▼ ┌──────────────────────────────────────┐ │ PipelineStore (C++ Core) │ LibraryLoader 按名字 dlopen .so │ Stack(name, libpath, config) │ 上层 → 下层,逐层下传 └──────────────────┬───────────────────┘ ▼ ┌──────────── CacheStore (.so) ────────┐ │ TransBuffer: POSIX 共享内存缓冲区 │── 命中(80–95%) ─▶ 直接返回,微秒级 │ 未命中 → 继续下传 │ └──────────────────┬───────────────────┘ ▼ ┌────────── CompressStore (.so) ───────┐ │ Load: 解压 Dump: 压缩(2–4x) │ 压缩计算与"内存→磁盘"的传输等待重叠 └──────────────────┬───────────────────┘ ▼ ┌──────────── PosixStore (.so) ────────┐ │ TransManager: LoadQueue / DumpQueue │ 读写队列分离 + 批量聚合 │ IoEngine: AIO(高并发) / Psync(低时延) │ └──────────────────┬───────────────────┘ ▼ 本地磁盘 / NVMe这张图和上面那张图加起来,就是本文之后八个章节的骨架:第 2–3 节讲“为什么这么切”,第 4–6 节讲“切完之后每一层怎么跑快”,第 7–8 节讲“怎么保证切完还能改”。想看这套东西在 v2 接口层面上的契约是怎么写的,可以直接看同系列的 UCM v2 接口设计契约;那篇是接口规范,这篇是存储内核的运行时结构,两篇不重叠。
2. Pipeline 的收益从哪来:拦截、隔离、流水
官方文档给 Pipeline 算了三笔账,我按“收益的可信度”从高到低重排了一下。
第一笔是拦截。 Cache 层检查共享内存缓冲区里有没有命中数据,这个动作本质是一次内存查表,文档的说法是纳秒级(nanosecond-level)。没命中才继续往下走。因为高频访问的数据在 Cache 层就被拦住了,文档称系统因此避免了超过 90% 的磁盘 IO 操作,平均访问延迟从毫秒级压到微秒级。这里有两个容易被混用的数字要分开看:90%+ 是“被 Cache 层拦下来的 IO 比例”,80–95% 是第 5 节里 TransBuffer 的命中率——两个口径不同,别互相代入。
第二笔是隔离。 分层不只是为了“多一层”,而是为了让每层可以朝各自的最优方向独立调优:Cache 层可以放心用无锁哈希表,因为它的瓶颈在并发查表;Compressor 层可以选 CPU 密集型的压缩算法,因为它的瓶颈在算力;Posix 层专心做 IO 调度,因为它的瓶颈在磁盘队列。单体架构里这三件事抢同一份资源、改一处牵动全局;拆开之后互不干扰。
第三笔是流水。 这是 Pipeline 这个名字真正的来源——文档明确说数据流设计借鉴了 CPU 流水线。连续提交多个 Block 的 Load/Dump 时,各层同时有活干:
时间 ──────────────────────────────────────────────▶
B1: [Cache 检查][Compress][Posix 写盘]B2: [Cache 检查][Compress][Posix 写盘]B3: [Cache 检查][Compress][Posix 写盘]
每层的吞吐被下一个 Block 填满 → 整体吞吐趋近"各层吞吐之和",而不是串行的"各层耗时相加"。文档给出的口径是:Pipeline 模式吞吐相比单体架构提升 2–3x,高并发场景优势更明显。这个数字的可信度我认为是三个里最低的——它没有说明对比基线是什么形态的单体架构、也没有给测试条件,属于设计意图的量化表达。
三笔账摊开在一张表里,各自的收益来源和可信度就清楚了:
| 收益 | 机制 | 文档口径 | 我的可信度判断 |
|---|---|---|---|
| 少做 IO | Cache 层内存查表拦截,未命中才下传 | 避免 90%+ 磁盘 IO;ms → µs | 高,机制自明,量级合理 |
| 各自最优 | 层间资源不争抢,可独立选型 | 定性结论,无数字 | —(架构判断,不需要数字支撑) |
| 吞吐叠加 | 各层流水并行,连续提交时互不空等 | 相比单体架构 2–3x | 中,缺对比基线与测试条件 |
3. 压缩层的位置:为什么要夹在 Cache 与 Posix 之间
这是整篇文档里我最愿意单独拎出来讲的一个决策:压缩层放哪一层,答案几乎是唯一的,而第一次想很容易放错。
文档的说法很直白:Compressor 层位于 Cache 与 Posix 之间,于是
- 热数据不需要压缩——它已经命中 Cache 层,直接在共享内存里以原始格式被访问;
- 冷数据自动压缩——只有未命中的、真要落盘的数据才在写入前压一次,读的时候自动解压。
对 16 字节的 BlockId 所对应的大块 KV 张量,文档给出的压缩比是 2–4x,直接减少磁盘空间占用与 IO 传输量。但真正精妙的地方不在压缩比,而在时机:压缩发生在“数据正从内存流向磁盘”的这个窗口里,而这段窗口本来就要等 IO。压缩计算被塞进 IO 等待里,于是计算与 IO 并行,压缩带来的额外耗时被部分隐藏掉了——文档的原话是“利用内存到磁盘的传输延迟,使压缩计算与 IO 等待重叠”。
反过来验证这个位置的唯一性,三个候选位置各自会出什么问题:
| 压缩层位置 | 热数据(命中)会怎样 | 时机能否与 IO 重叠 | 结论 |
|---|---|---|---|
| Cache 之上(最上层) | 命中也要走一遍压缩/解压路径,白白付费 | 不能,压缩在 IO 之前串行 | 把最快的路径拖慢,等于消灭 Cache 层收益 |
| Cache 与 Posix 之间 | 命中直接返回,完全不进压缩层 | 能,压缩与传输重叠 | 文档选的位置,热路径零成本 |
| Posix 之下(磁盘之后) | 数据已落盘,压缩语义上不成立 | 不能,没有传输窗口 | 无法实现,且失去“减少 IO 传输量”的收益 |
这张表是我自己的推演,不是文档原文——文档只正面说了“夹在中间”的理由,反例是我补的。但如果你在别的系统里看到压缩层被放到文件系统之下的块设备层,那它追求的一定不是“热数据零成本”,而是全局空间效率之类的目标,这两件事没法同时最优。
压缩层内部还有一处内存管理的细节值得记一笔:文档说 Compressor 实现了独立的 Memory Pool,在 Setup 阶段预分配压缩/解压所需的临时缓冲区(FSE、Huf 这类算法都需要中间状态缓冲),之后每次压缩直接从池里取、用完归还,把“动态分配 + 释放”从热路径上彻底移除。文档给出的口径是 100 个 Block 的批量压缩从 300ms 降到 250ms,约 20% 提升(未复现)。20% 听起来不多,但这是纯管理开销的净损失,在批量压缩这种场景里是白送的分。
4. 异步任务体系:Split 切片、TaskQueue 与 TaskSet
第 2–3 节解决的是“单次操作怎么不浪费”,这一节解决的是“成百上千次操作怎么排队”。UCM 的答案分四段:切片、排队、失败隔离、超时保护。
切片(Split)。 一个 Task 里通常有多个 Shard——比如一次同时加载 100 个 Block 的 KV Cache。系统的做法是用 Split 把这些 Shard 切成若干子任务,再用 Round-Robin 分派到多个 TaskQueue。注意这里特别强调“不是随机分配”:队列数量按 CPU 核数或 IO 通道数配置,每个子任务分到的 Shard 数量相近,负载均匀。文档举的算例是:单队列串行处理 100 个 Block 需要 1000ms(假设每个 Block 10ms),10 队列并行理论上降到 100ms 左右。
// 按文档 §II 的描述还原的切片与派发骨架(非官方源码,仅示意语义)Expected<TaskHandle> TaskManager::Submit(const TaskDesc &desc) { // desc.shards 里是本次要处理的全部 Shard(例如 100 个 Block) auto parts = TaskShard::Split(desc.shards, queue_num_); // 按队列数切片 for (size_t i = 0; i < parts.size(); ++i) { queues_[i % queues_.size()]->Push(parts[i]); // Round-Robin 入队 } return waiter_.Register(parts); // 立即返回,调用线程不阻塞}排队(生产者-消费者)。 Submit 把切片推进多个队列后立即返回,不阻塞调用线程;队列背后各有一个 Worker 线程持续消费;调用线程通过 Wait 或 Check 异步收口结果。三个效果:调用线程可以连续提交多个 Task 形成批提交流水;Worker 不空转;多队列形成并行流水,吞吐叠加。文档点名了 vLLM 的 Prefill 阶段是这套设计的最大受益者——一次批量提交数百个 Block 的 Load 请求,异步等待期间 GPU 继续算,KV Cache 加载与 GPU 计算形成重叠。
Submit(Task: 100 Shards) │ ├── Split ──▶ 切成 queue_num_ 份,每份 Shard 数相近 │ ▼ Round-Robin ┌────┬────┬────┬─────┬────┐ ▼ ▼ ▼ ▼ ▼ ▼ Q0 Q1 Q2 Q3 ... Q9 ← TaskQueue(队数按 CPU 核 / IO 通道数配) │ │ │ │ │ │ Worker Worker Worker ... Worker → 持续消费,管道不空 └────┴────┴────┴─────┴────┘ │ ▼ TaskWaiter / TaskSet ← 调用线程在这里异步收口,也可超时退出失败隔离(TaskSet)。 这是我认为最容易被低估的一段。一个 Task 里某个 Shard 处理失败时,失败信息记进 failureSet,但不影响其他 Shard 继续处理。文档给了一个很有说服力的对照:假设一个 Task 含 50 个 Block,其中 1 个因为磁盘故障加载失败——传统设计会把整个 Task 标失败,另外 49 个成功加载的结果一起被丢弃;TaskSet 机制下 49 个立即可用,只有那 1 个走重试或降级。文档给出的口径是磁盘抖动场景下有效吞吐提升 3–5x(未复现)。这里的逻辑链是自洽的:抖动场景的损失本来就是“被连坐的成功结果”,隔离掉连坐,收益自然按失败率的倒数放大。
超时保护(Wait)。 TaskManager 的 Wait 带一个 timeoutMs 阈值,超时就强制返回并标记失败,避免无限等待把资源占死。在分布式存储场景这一条几乎是必须的:某个存储节点响应慢时,超时机制让它快速失败、触发降级策略(读本地缓存或直接重算),而不是把整个推理请求拖住。文档还补了一个容易被忽略的细节——超时之后 Waiter 仍然继续等底层操作完成,目的是保证资源被正确释放(共享内存缓冲区、磁盘文件句柄),否则超时本身会变成泄漏源。“逻辑上放弃、资源上收尾”,这个分寸感是这类系统里最容易写错的地方。
顺带说一句:切片在多队列上的实际加速,文档在不同小节给了两个口径。§II 说“由于 IO 引擎的批量处理能力,实测提升常超过理论值,达到 10–15x”;§VIII 又说“单队列处理 100 个 Block 耗时 150ms,10 队列 40ms,约 4x”。这两个数字对应的场景(Block 大小、是否批量聚合、存储介质)文档没交代,我只能如实并列,别把它们当成同一个测试的两组数字。
5. 缓存层级:TransBuffer 快路径与读写队列分离
第 2 节说 Cache 层拦掉了 90%+ 的磁盘 IO,这一节讲它具体靠什么拦。
快路径靠共享内存。 BufferManager 管理的 TransBuffer 基于 POSIX 共享内存实现,文档称其提供纳秒级数据访问。BlockId 被 Lookup 时,系统先查 TransBuffer:命中就直接从共享内存读,绕开 IO;未命中才触发后端存储的 Lookup。在 Prefix Caching 场景下这个设计的收益最大,因为同一个 Prompt 前缀对应的 KV Cache 会被反复访问——文档口径是 TransBuffer 命中率可达 80–95%,平均延迟从毫秒级降到微秒级。
共享内存的第二个好处是跨进程。vLLM 的推理架构是多进程的,不同 Worker 可能访问同一个前缀的 KV Cache,TransBuffer 让它们共享同一份数据,不必各自重复加载。文档给出的口径是 4 进程场景下 IO 量减少 60–70%。同一份数据在 4 个进程里各存一份要 400MB,共享内存方案只要 100MB,内存占用降 75%——这个算例是文档自己举的,数字对得上,属于可信度较高的一类。共享内存这块的缓冲池还有一层优化:Setup 阶段预分配一批 buffer block,之后按需取用归还,替代频繁的共享内存分配释放,文档口径是 100 个 Block 连续加载从 15ms 降到 8ms(约 2x,未复现)。
前缀查询靠“反向问一次”。 传统的 Lookup 是一个 Block 一个 Block 地查,返回 List[bool] 表示逐块命中情况;LookupOnPrefix 直接返回最长匹配前缀的索引——系统只需要找到第一个未命中的 Block 在哪,前缀长度就出来了。这一个语义改动把复杂度从 O(n) 降到 O(log n) 甚至 O(1)。SpaceManager 里的实现还叠加了并行扫描:多个 Worker 分段检查,通过原子变量快速定位首个失败位置,用 Latch 同步收口。文档口径是 1000 个 Block 的前缀查询从 15ms 降到约 3ms,5x(未复现)。
读写分家靠两条队列。 CacheStore 的 TransManager 把 LoadQueue 和 DumpQueue 拆开,文档列了三条混用一条队列的病:大的 Dump 阻塞紧急的 Load;Load 被 Dump 的长耗时拖慢;读写混在一起在磁盘上退化成随机 IO。拆开之后,Prefill 阶段批量的 Load 可以连续调度 IO 引擎做大块读,Decode 阶段的 Dump 异步写,互不干扰。文档口径是 Load 操作的延迟稳定性提升 40%,P99 从 8ms 降到 3ms(未复现)。P99 这个指标比均值更能说明问题——队列分离解决的本来就不是平均延迟,而是尾延迟。
批量聚合靠“等一小下”。 两个队列还都实现了请求聚合:多个 Load 请求连续到达时,队列不立刻逐个调度,而是短暂等待(文档说微秒级)收集更多请求,然后把相邻 Block 的请求合并成一次批量 IO。三个收益:多次小读变一次大读,减少 IO 次数;AIO 引擎可以并发提交多个请求,提高 IO 并发度;磁盘寻道从 N 次变成 1 次。文档口径是 100 个 Block 的加载从 150ms 降到约 80ms,约 2x(未复现)。这一条和第 6 节的 AIO 是同一套东西的两面:聚合负责“攒成一批”,AIO 负责“一批发出去不等”。
把这一节的优化点摊开:
| 优化点 | 机制 | 文档口径 |
|---|---|---|
| 共享内存快路径 | TransBuffer 命中即返回,跨进程零拷贝 |
命中率 80–95%;4 进程 IO 量 −60–70% |
| 缓冲区池 | Setup 预分配,取还替代分配释放 |
100 Block 加载 15ms → 8ms(约 2x) |
| 批量前缀查询 | LookupOnPrefix 返回最长匹配索引 + 并行扫描 |
1000 Block 15ms → 3ms(5x);O(n) → O(1) |
| 读写队列分离 | LoadQueue / DumpQueue 独立调度 |
Load P99 8ms → 3ms;稳定性 +40% |
| IO 批量聚合 | 微秒级等待 + 相邻 Block 合并成批 | 100 Block 150ms → 80ms(约 2x) |
这张表里的每一项都是“未在本地复现的官方口径”。我保留它们的价值在于横向排序:如果这些相对关系成立,那么性价比最高的是 LookupOnPrefix(5x)和队列分离(P99 降 62%),而缓冲区池与内存池那 20%–2x 属于收尾工作。
顺带提一句同系列的另一篇:共享内存缓存的并发控制 会把 TransBuffer 在并发读写下的正确性问题单独展开,那部分本文没有涉及;多 rank 共享加载 讲的是 TransBuffer 跨进程共享在张量并行场景下的进一步延伸。
6. IO 引擎抽象:AIO 与 Psync 的双实现与动态切换
到 Posix 层,最后一步是“真的把字节写到磁盘”。这里 UCM 没有二选一,而是实现了两套引擎。
IoEngineAio 基于 Linux AIO(libaio):一批 IO 请求通过 io_submit 提交进内核,再用 io_getevents 异步回收完成事件。它的优势都在高并发侧——可以同时挂几百个请求让内核并发调度;调用线程不被阻塞,可以继续提交或处理已完成的;请求在内核层被合并,减少物理 IO 次数。文档口径是高并发 Load 场景(比如 Prefill 阶段同时加载数百个 Block)AIO 吞吐是 Psync 的 3–5x,500 个 Block 并发加载从 1200ms 降到约 400ms(未复现)。
IoEnginePsync 基于 POSIX 的 pread/pwrite,是同步 IO。它当然会阻塞调用线程,但在低负载场景有三个实实在在的好处:没有 AIO 的初始化开销,第一次 IO 的延迟更低;请求立即执行,没有排队等待;行为确定,调试和排障简单。文档口径是低负载或 Debug 场景下单次 IO 延迟比 AIO 低 20–30%。
| 维度 | IoEngineAio(libaio) |
IoEnginePsync(pread/pwrite) |
|---|---|---|
| 并发模型 | io_submit 批量提交 + io_getevents 异步收 |
同步阻塞,一请求一等待 |
| 强项 | 高并发吞吐,数百请求同时在飞 | 单次低时延,无初始化开销 |
| 文档口径 | 高并发下 3–5x 于 Psync;500 Block 1200→400ms | 低负载下单次 IO 延迟低 20–30% |
| 适合场景 | 生产环境、Prefill 阶段批量 Load | 开发调试、低负载、需要确定性行为 |
| 代价 | 初始化开销、行为依赖内核与文件系统支持 | 调用线程被阻塞,并发一高就退化成串行 |
切换方式是这套设计里很干净的一处:TransManager 的 Setup 按 config.ioEngine 字段选择引擎实例,LoadQueue 和 DumpQueue 统一调 ioEngine_->Submit(),具体实现被隔离在接口后面。
# TransManager::Setup 读取的键(文档口径为 config.ioEngine,此处按语义示意)ioEngine = aio # 高并发:内核并发调度,吞吐优先ioEngine = psync # 低负载 / 调试:无初始化开销,单次时延优先文档强调:运行时换引擎只需要改配置重新 Setup,不需要重编译、不需要重启系统。这个能力把“部署形态差异”从编译期决策降级成了配置期决策——开发环境用 psync 图调试方便,生产环境切 aio 提吞吐,同一份二进制。对要同时交付多种部署形态的产品来说,这类设计的价值往往比单点性能更高。
7. 可扩展性:.so 热插拔、Builder 注册与 Dictionary
前五节都在讲怎么快,这一节讲怎么改。UCM 的扩展性不是靠“预留接口”这种口头承诺,而是靠四件具体的机制堆起来的。
第一件:每个组件都是一个独立的 .so。 Cache、Compressor、Posix 各自编译成动态库,运行时由 LibraryLoader 动态加载。这一条决定了后面两件事的上限——组件边界等于二进制边界,换组件就是换文件。
第二件:Stack 做栈式组装。 PipelineStore 通过 Stack(name, libpath, config) 把组件按上层到下层压进管线,config 是这一层自己的配置。数据流就是“上层 → 下层,逐级处理”,没有别的花样。
第三件:Builder 把“组合”变成可注册的一等公民。 文档列了三个预置 Builder:
_cache_compress_posix_pipeline_builder:压缩存储组合(Cache + Compressor + Posix);_cache_posix_pipeline_builder:纯缓存组合(Cache + Posix),不压缩;_posix_pipeline_builder:纯存储组合(只有 Posix)。
文档里还出现过 Cache|Ds3fs(分布式存储场景)、Posix、Fake、Empty 这几种预置组合名。注册是一行的事:
// 按文档 §V 与架构图的语义还原(非官方源码)register("Cache|Compress|Posix", _cache_compress_posix_pipeline_builder);register("Cache|Posix", _cache_posix_pipeline_builder);register("Posix", _posix_pipeline_builder);
// Builder 内部负责"配置怎么传给每一层",可以算派生量:// _build_cache_compress_posix_pipeline 会按 block_size / shard_size// 动态算出压缩后的 tensor_size,再写进 Compressor 的 Dictionary。Builder 这一层最见功力的地方正是那个派生计算:tensor_size 这种“由别的配置算出来”的参数,放在组件里硬编码就把组合写死了,放在 Builder 里则由组合自己决定怎么传。文档明确说,同一个组件在不同组合里可以收到不同配置——这才是“可组合”和“能同时装进去”的区别。
第四件:Dictionary 承住所有配置。 底层就是 std::unordered_map<std::string, std::any>,一种类型能装下任何配置值。带来的三个能力:Pipeline 把顶层配置分发给各层;每个组件定义自己的配置项不影响别人;Builder 里可以动态生成配置项。新组件要新配置项时,加一对 key-value 就行,配置文件系统本身不用改。
在这之上,Python 侧还有两层扩展便利:UcmConnectorFactory 用懒加载注册表,把 Connector 的 import 推迟到 create_connector 真正被调用时才发生——文档口径是 UCM 模块初始化时间从 3s 降到约 0.5s,且单个 Connector 的 import 出错不会拖垮其他 Connector;UcmConnectorFactoryV1 进一步支持运行时指定 module_path,外部独立开发的 Connector 类不进 UCM 代码库也能被加载。
把扩展能力按代价排一下,这张表比文档的分节更有指导性:
| 想做的事 | 要动的文件 | 是否重编译 | 是否重启 | 风险面 |
|---|---|---|---|---|
| 换压缩算法 | 替换 Compressor 的 .so | 只编这个 .so | 不一定(文档称特定场景可热升级) | 单组件 |
| 换存储介质/IO 引擎 | 替换 Posix 的 .so,或改 ioEngine 配置 |
替换型需编 .so;改配置不需要 | 改配置需重新 Setup |
单组件 |
| 新增一种组合 | 新增一个 Builder 函数 + register 一行 |
编译 Core 或外部模块 | 需重启 | 组合层 |
| 新增一种组件类型 | 新写一个 .so + 新组合 | 只编新组件 | 需重启 | 新增,不触碰既有 |
有一点需要说明:文档说的“功能扩展”是“放进指定目录、通过 Stack 注册,不修改任何既有代码”。而“性能扩展”能做到不重启,是因为组件替换的语义是旧组件把手上任务做完、新组件接后续任务——文档原话是在某些场景下可实现热升级。我理解为“设计上留了口子”,不是默认行为,文档没给操作流程和验证方法。
8. 契约层:16 字节 BlockId、Expected 与双版本接口
最后回到最底层:UCM 用什么样的类型和接口把上面这一切固定住。这一节表面上是“类型设计”,实际上是在回答一个问题——性能优化做到最后,往往要靠把不确定性从类型系统里删掉。
8.1 BlockId:定长 16 字节,把三个开销一次性消掉
BlockId 定义为 std::array<std::byte, 16>。文档给了三条理由,每一条都对应一类具体开销:
// 按文档 §VI 与架构图还原using BlockId = std::array<std::byte, 16>; // 16 字节定长,直接当 16-byte hash 用
struct Shard { // 架构图口径:owner / index / addrs /* owner, index, addrs */};
struct TaskDesc { // 架构图口径:vector<Shard> + brief + prerequisiteHandle std::vector<Shard> shards; /* brief */ void *prerequisiteHandle = nullptr; // 扩展位:例如 GPU stream 同步句柄};
using Dictionary = std::unordered_map<std::string, std::any>; // 统一配置容器- 免动态分配:字符串形态的 block_id 每次创建都要分配内存,批量操作下分配/释放的累计开销很可观;定长数组可以直接内嵌进结构体,不需要额外分配。
- 哈希变 O(1):
BlockIdHasher直接把 16 字节当string_view来算哈希,不用逐字符遍历、不用检查长度,复杂度从 O(n)(n 为字符串长度)变成 O(1)。文档口径是 Lookup 需要大量哈希的场景下,单个 Block 的哈希从 50ns 降到约 10ns(未复现)。 - 内存布局变好:
BlockId能直接内嵌到Shard、TaskDesc里,不用指针间接访问,局部性更好;在 Pipeline 各层之间随Shard传递时也不需要额外拷贝。
这三条里,我认为第二条的数字(50ns → 10ns)最不需要怀疑——它是算法复杂度改变带来的常数级差异,量级完全对得上。但它也提醒了一件事:这类优化只有在“哈希本身成为热点”时才值钱。如果一层 Pipeline 的耗时大头在 IO 上,省 40ns 没有意义。
8.2 Expected:不用异常的错误传递
Expected 借鉴 Rust 的 Result,用返回值携带错误信息,而不是抛异常。文档列的异常开销是三条:抛异常要构造异常对象并展开栈帧;捕获要遍历 catch 块匹配类型;异常路径要维护异常表,增加代码体积。Expected 则把成功数据或错误状态直接编码在返回值里,用 .has_value() / .Value() 检查,错误沿返回值链传递。
文档口径:在一次失败率 10% 的 Lookup 操作里,异常模式耗时 15ms,Expected 模式 12ms,约 20% 提升(未复现)。这个数字量级合理——10% 的失败率不算低,异常路径的开销被摊到足够多的调用上才显出 20%。
Expected 还顺手解决了另一个问题:它不只带 Status 错误码,还带错误消息字符串。在 Pipeline 的多层流转里,每层都能返回精确描述(文档举的例子是 “failed to load block: disk timeout”),上层能直接定位根因,不用去全局日志里反推。而错误消息按需存储,成功路径上没有额外开销——错误信息的丰富度和成功路径的性能并不必然冲突,前提是只在错误路径上付费。
8.3 StoreV1 与双版本接口:怎么让升级不砸人
StoreV1 是所有组件必须实现的统一边界,架构图里给了完整签名:
// 还原自官方架构图 C++ Core 层的 StoreV1 抽象接口class StoreV1 {public: virtual Status Setup(const Dictionary &config) = 0; virtual Expected<std::vector<uint8_t>> Lookup(const BlockId *ids, size_t num) = 0; virtual Expected<TaskHandle> Load(const TaskDesc &desc) = 0; virtual Expected<TaskHandle> Dump(const TaskDesc &desc) = 0; virtual Expected<bool> Wait(TaskHandle h) = 0; virtual Expected<bool> Check(TaskHandle h) = 0; // Prefetch 为预留方法:组件可实现也可不实现};这个接口同时承担两个相反方向的职责:约束和预留。约束是六个核心方法必须实现,Pipeline 才能统一调度任意组件,组件才能无缝替换;预留是 TaskDesc 可以携带组件自定义的扩展字段(典型例子是 prerequisiteHandle,用于 GPU stream 同步),Prefetch 可以只留方法不实现,组件按需处理或直接忽略。文档把这个组合叫“约束 + 预留”,意思是扩展只能在边界内发生,不会把既有调度逻辑撞坏。
再往上一层是 Python API 的双版本并存。架构图上 UcmKVStoreBaseV1 的形态是这样的:
# 还原自官方架构图 Python API 层class UcmKVStoreBaseV1: def lookup(self, block_ids) -> List[bool]: ... def load(self, block_ids, tensors) -> Task: ... def dump(self, block_ids, tensors) -> Task: ... def prefetch(self, block_ids) -> None: ... def wait(self, task): ... def check(self, task): ... def cc_store(self) -> int: ... # 取底层 C++ 对象的裸指针新旧两个接口系列的差异,文档口径是:
| 维度 | UcmKVStoreBase(文档称 v1 接口) |
UcmKVStoreBaseV1(文档称 v2 接口) |
|---|---|---|
| block_id | 字符串形态,简单直观 | bytes 形态,更高效,且支持 shard_index |
| Connector 工厂 | UcmConnectorFactory(服务 v1 的 Connector) |
UcmConnectorFactoryV1(服务 v2 的 Connector) |
| 典型配置项 | storage_backends、kv_block_size |
block_size、shard_size、tensor_size |
| 迁移策略 | 老系统可继续用,不强制升级 | 新系统直接用,拿到性能优势;升级路径平滑,不需要一次性改全部代码 |
这里有个命名上的坑必须提醒:后缀 V1 指的是“新一代接口的第一版”,不是“旧的 v1 接口”。文档里的 UcmKVStoreBaseV1 被称作 v2 接口(bytes 形态),而 UcmKVStoreBase 才是旧的那套(字符串形态)。文档本身没把两个类名和 v1/v2 标签一一对齐,我是拿仓库代码核对过的:ucm/store/ucmstore.py 里的 UcmKVStoreBase 用 List[str] 的 block_ids,ucm/store/ucmstore_v1.py 里的 UcmKVStoreBaseV1 用 List[bytes],且 load() 多了一个 shard_index: List[int] 参数——与文档描述完全对得上,这个映射可以放心用。读的时候别被后缀绕进去。
双版本能真正并存,靠的还是 Dictionary:v1 的 storage_backends/kv_block_size 和 v2 的 block_size/shard_size/tensor_size 可以同时躺在一个字典里,两代 Connector 各取所需,旧配置在新系统里继续有效。配置系统的类型自由度,在这里变成了版本兼容的缓冲垫——这是我在整篇文档里觉得最“顺手”的一处设计,它没有为版本迁移专门写任何迁移代码。
9. 小结
UCM Store 的 Pipeline 架构,本质上是把“存储”这个动作按职责切开,再用契约粘回去:
- 切分维度是职责,不是技术栈:查缓存、压缩、落盘、调度 IO 各自独立成 .so,核心层只负责加载与逐层下传,不含任何存储策略;
- 收益主要来自三处:Cache 层拦掉 90%+ 的磁盘 IO(毫秒级降到微秒级)、压缩层利用内存到磁盘的传输窗口把压缩计算藏进 IO 等待(2–4x 压缩比)、连续提交时各层流水并行(文档口径 2–3x);
- 异步任务体系是并发的放大器:Split 切片 + Round-Robin 到多队列 + 生产者消费者流水,把批提交变成常态;TaskSet 的失败隔离让“一个 Block 坏掉”不再连坐整个 Task;
Wait超时“逻辑放弃、资源收尾”; - 缓存层级解决尾延迟:
TransBuffer共享内存快路径(命中 80–95%)、LookupOnPrefix把前缀查询从 O(n) 压到近似 O(1)、读写队列分离把 P99 从 8ms 压到 3ms、批量聚合让寻道从 N 次变 1 次; - IO 引擎把部署差异降级成配置差异:AIO 走吞吐(3–5x),Psync 走单次时延(低 20–30%),
config.ioEngine一改即切,不重编译不重启; - 可扩展性靠四层机制叠加:.so 热插拔 →
Stack栈式组装 →Builder注册组合 →Dictionary装配置;再叠一层 Python 侧懒加载(3s → 0.5s); - 契约层是把不确定性删掉:16 字节定长
BlockId(哈希 50ns → 10ns)、无异常的Expected(10% 失败率下 15ms → 12ms)、StoreV1的“约束 + 预留”、双版本接口共存。
关于数字,我想再强调一次本文的纪律:上面所有带单位的量化结论都来自官方文档正文,没有一个是我在本地复现的;文档内的算例(“假设每个 Block 需要 10ms 所以 100 个要 1000ms”)本身是推演,不是测量;切片加速在不同小节给出了 10–15x 和约 4x 两个口径,文档未说明场景差异,我如实并列。真正可以直接拿去用的,是这些机制本身和它们的相对排序,而不是那串数字。
一个我认为最值钱的判断:这套架构里最难被抄走的不是某个优化,而是“把编译期决策推迟到配置期”和“把组件边界画在二进制边界上”这两个习惯。 前者让同一份产物适配开发与生产两种形态,后者让“换组件”和“改代码”变成两件不相干的事——UCM 后面关于热插拔、Builder、双版本并存的叙述,都建立在这两个习惯之上。
这套架构的演化脉络(从早期双原语到现在这条 Pipeline)可以看 UCM 演进史;如果想看 Pipeline 之前 UCM 在混合模型场景下的分层设计思路,UCM 缓存系统分层设计报告 是更好的起点。
10. 参考来源
- 官方设计文档正文(PR 预览构建 build 954):Store Architecture
- 同一文档的 Markdown 原文(约 35KB,本文主要依据):store_architecture.md
- 本文配图来源:store-architecture.png
- 正式站点(截至 2026-10-23 尚未收录该页,
en/latest下返回 404):ucm.readthedocs.io - 站内同系列:UCM v2 接口设计契约、共享内存缓存的并发控制、多 rank 共享加载、UCM 演进史、UCM 缓存系统分层设计报告