KVCache 卸载方案技术竞争力对比:UCM vs 七家
这篇文章成稿于 2026-09-02,是当时基于公开材料做的一轮横向评估——文中所有评分、排名、差距清单与执行计划都是那个时点的判断,此后各家方案都还在演进,读的时候请带上时间戳。对比对象是八家:UCM、Mooncake、SGLang HiCache、LMCache、MemCache、NVIDIA Dynamo、TairKV、FlexKV,落点是技术选型而不是论文综述。文中的「UCM」指华为 ModelEngine 的 Unified Cache Manager(推理记忆数据管理器),也就是被反复拆解的那一方。文中图片点击可看原尺寸。
1. 执行摘要
- 综合排名:LMCache 27 > Dynamo 26.5 > TairKV 26 > UCM 24.5 > FlexKV 24 = Mooncake 24 > HiCache 22.5 > MemCache 19.5(满分 30。UCM 处在第一梯队下沿,不是落后,而是“偏科”。)
- UCM 最强项:架构解耦 5 / 特性完备 5 / 可演进性 5(全场唯一把“稀疏化算法”做成一等公民插件框架的卸载系统。)
- UCM 最弱项:可靠性 3 / 生态集成 3(缺全局元数据服务与跨实例 HA;主战场在昇腾,CUDA 侧存在感弱。)
五句话结论:
- 赛道已分层,拉平对比会误判。八个方案分布在「传输池化层 / 引擎内缓存层 / 全局管理层 / 编排层」四个不同位置,彼此既是竞品也是互补件——Mooncake 的 Transfer Engine 同时被 HiCache、LMCache、TairKV、FlexKV 当作底座。
- UCM 的护城河是“算法 × 系统”双栈,不是卸载本身。纯卸载(HiCache / FlexKV)已趋同质化;UCM 的
UcmSparseBase插件框架 + GSA/ESA/KVStar/Blend/Rerope 免训练稀疏算法,是唯一同时做到“省算 + 省存 + 复用”的方案。高置信 - 可靠性是 UCM 最大硬伤。TairKV 把中心化元数据 HA、多租户配额、版本协同写进设计目标;Dynamo 有 etcd leader/worker + G4 对象存储持久化;UCM 目前只有池内 LRU/TTL 与健康端点,缺集群级故障域设计。高置信
- 生态位次在 2026 年被 FlexKV 反超。FlexKV 一年内完成 vLLM(#34328)、NVIDIA Dynamo、TensorRT-LLM 三主干合入 + SGLang(#29701),Apache-2.0;UCM 仍以 ModelEngine / GitCode 为主场,CUDA 侧无框架主干合入。高置信
- MemCache 是盟友不是竞品。它是华为昇腾 MindCluster 的内存语义池化底座(GVA 统一编址),与 UCM 是“底座 + 管理层”的垂直互补关系;在昇腾 A3 超节点上应打包成
MemFabric → MemCache → UCM → vLLM-Ascend完整栈对外讲,单挑 Mooncake 反而贬低了自己。中置信
2. 赛道分层地图:别在错的层级上对比
把所有方案塞进一张表,最常见的错误是问“谁性能更好”。真实情况是它们解决的是不同层级的问题,而且上下游之间大量互相集成。
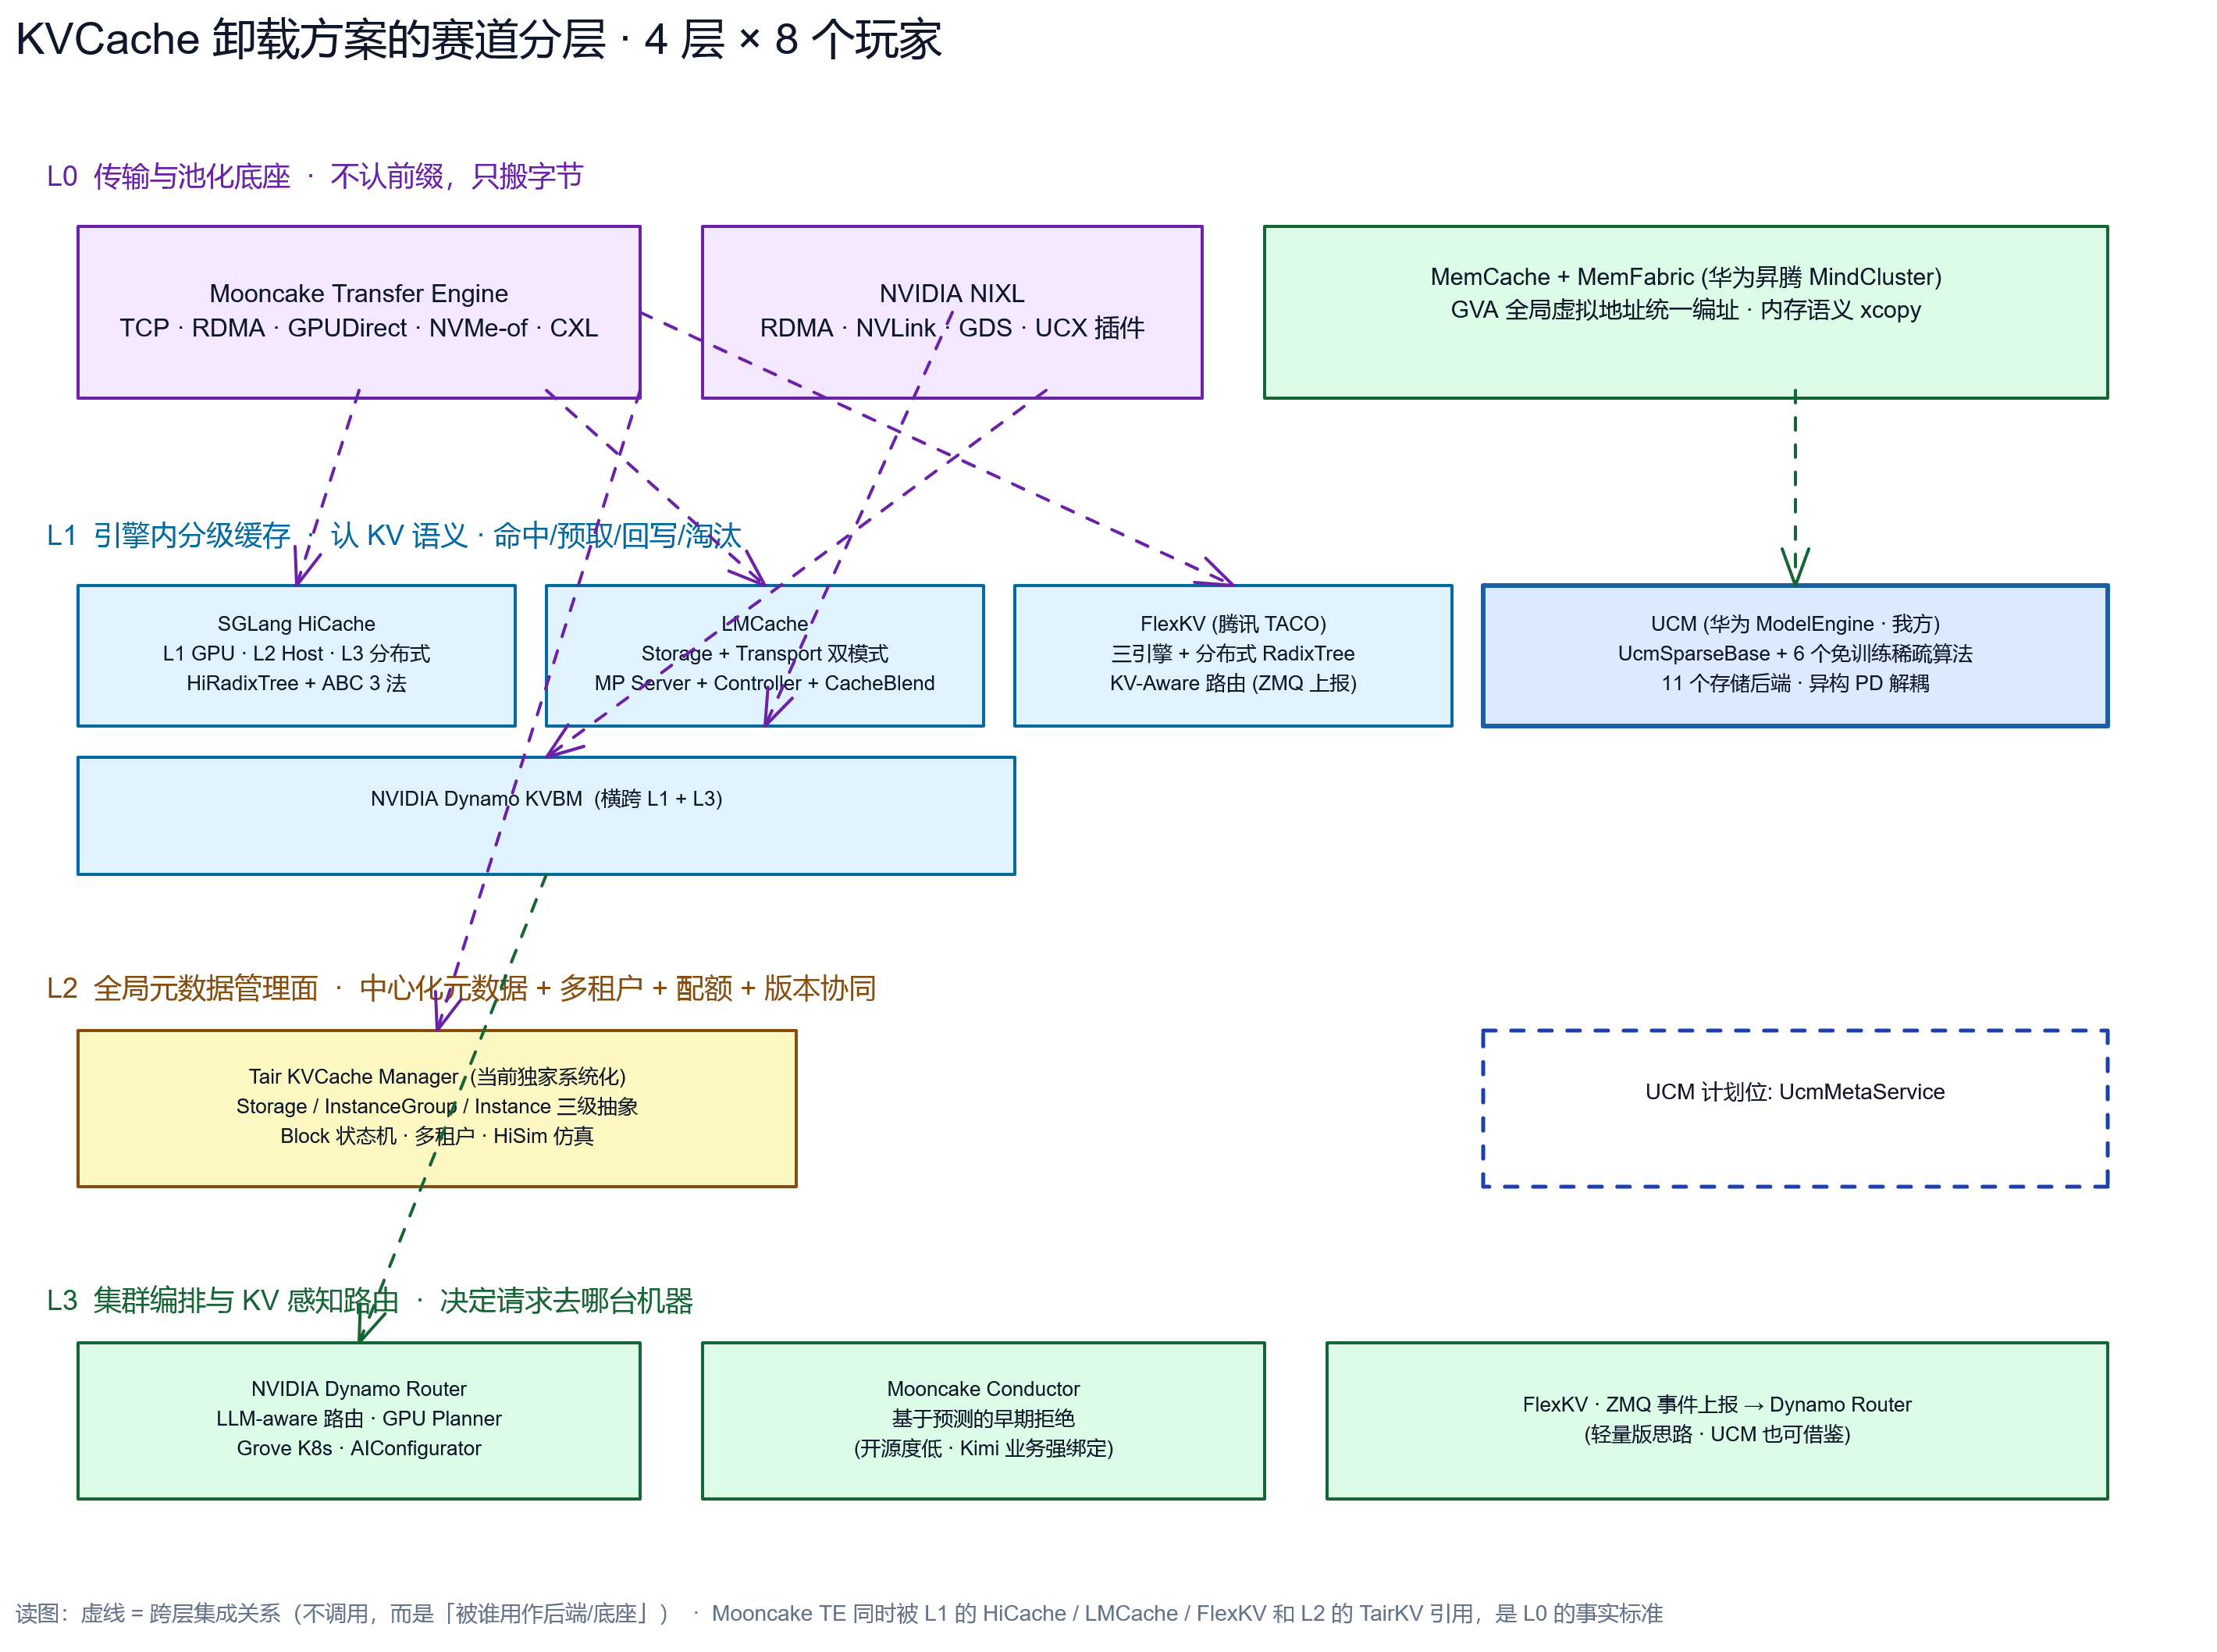
L0 · 传输与池化底座(Transport / Pooling)
Mooncake Transfer Engine(TCP/RDMA/GPUDirect/NVMe-of/CXL,拓扑感知多网卡聚合)、NVIDIA NIXL、MemCache + MemFabric(昇腾,GVA 统一编址内存语义)。
特征:不认识“前缀”,只提供跨节点、跨介质的高带宽字节搬运。Mooncake TE 是事实标准——它同时是 NIXL 的 backend plugin,并被 HiCache / LMCache / TairKV / FlexKV 直接引用。
L1 · 引擎内分级缓存(In-engine Tiering)
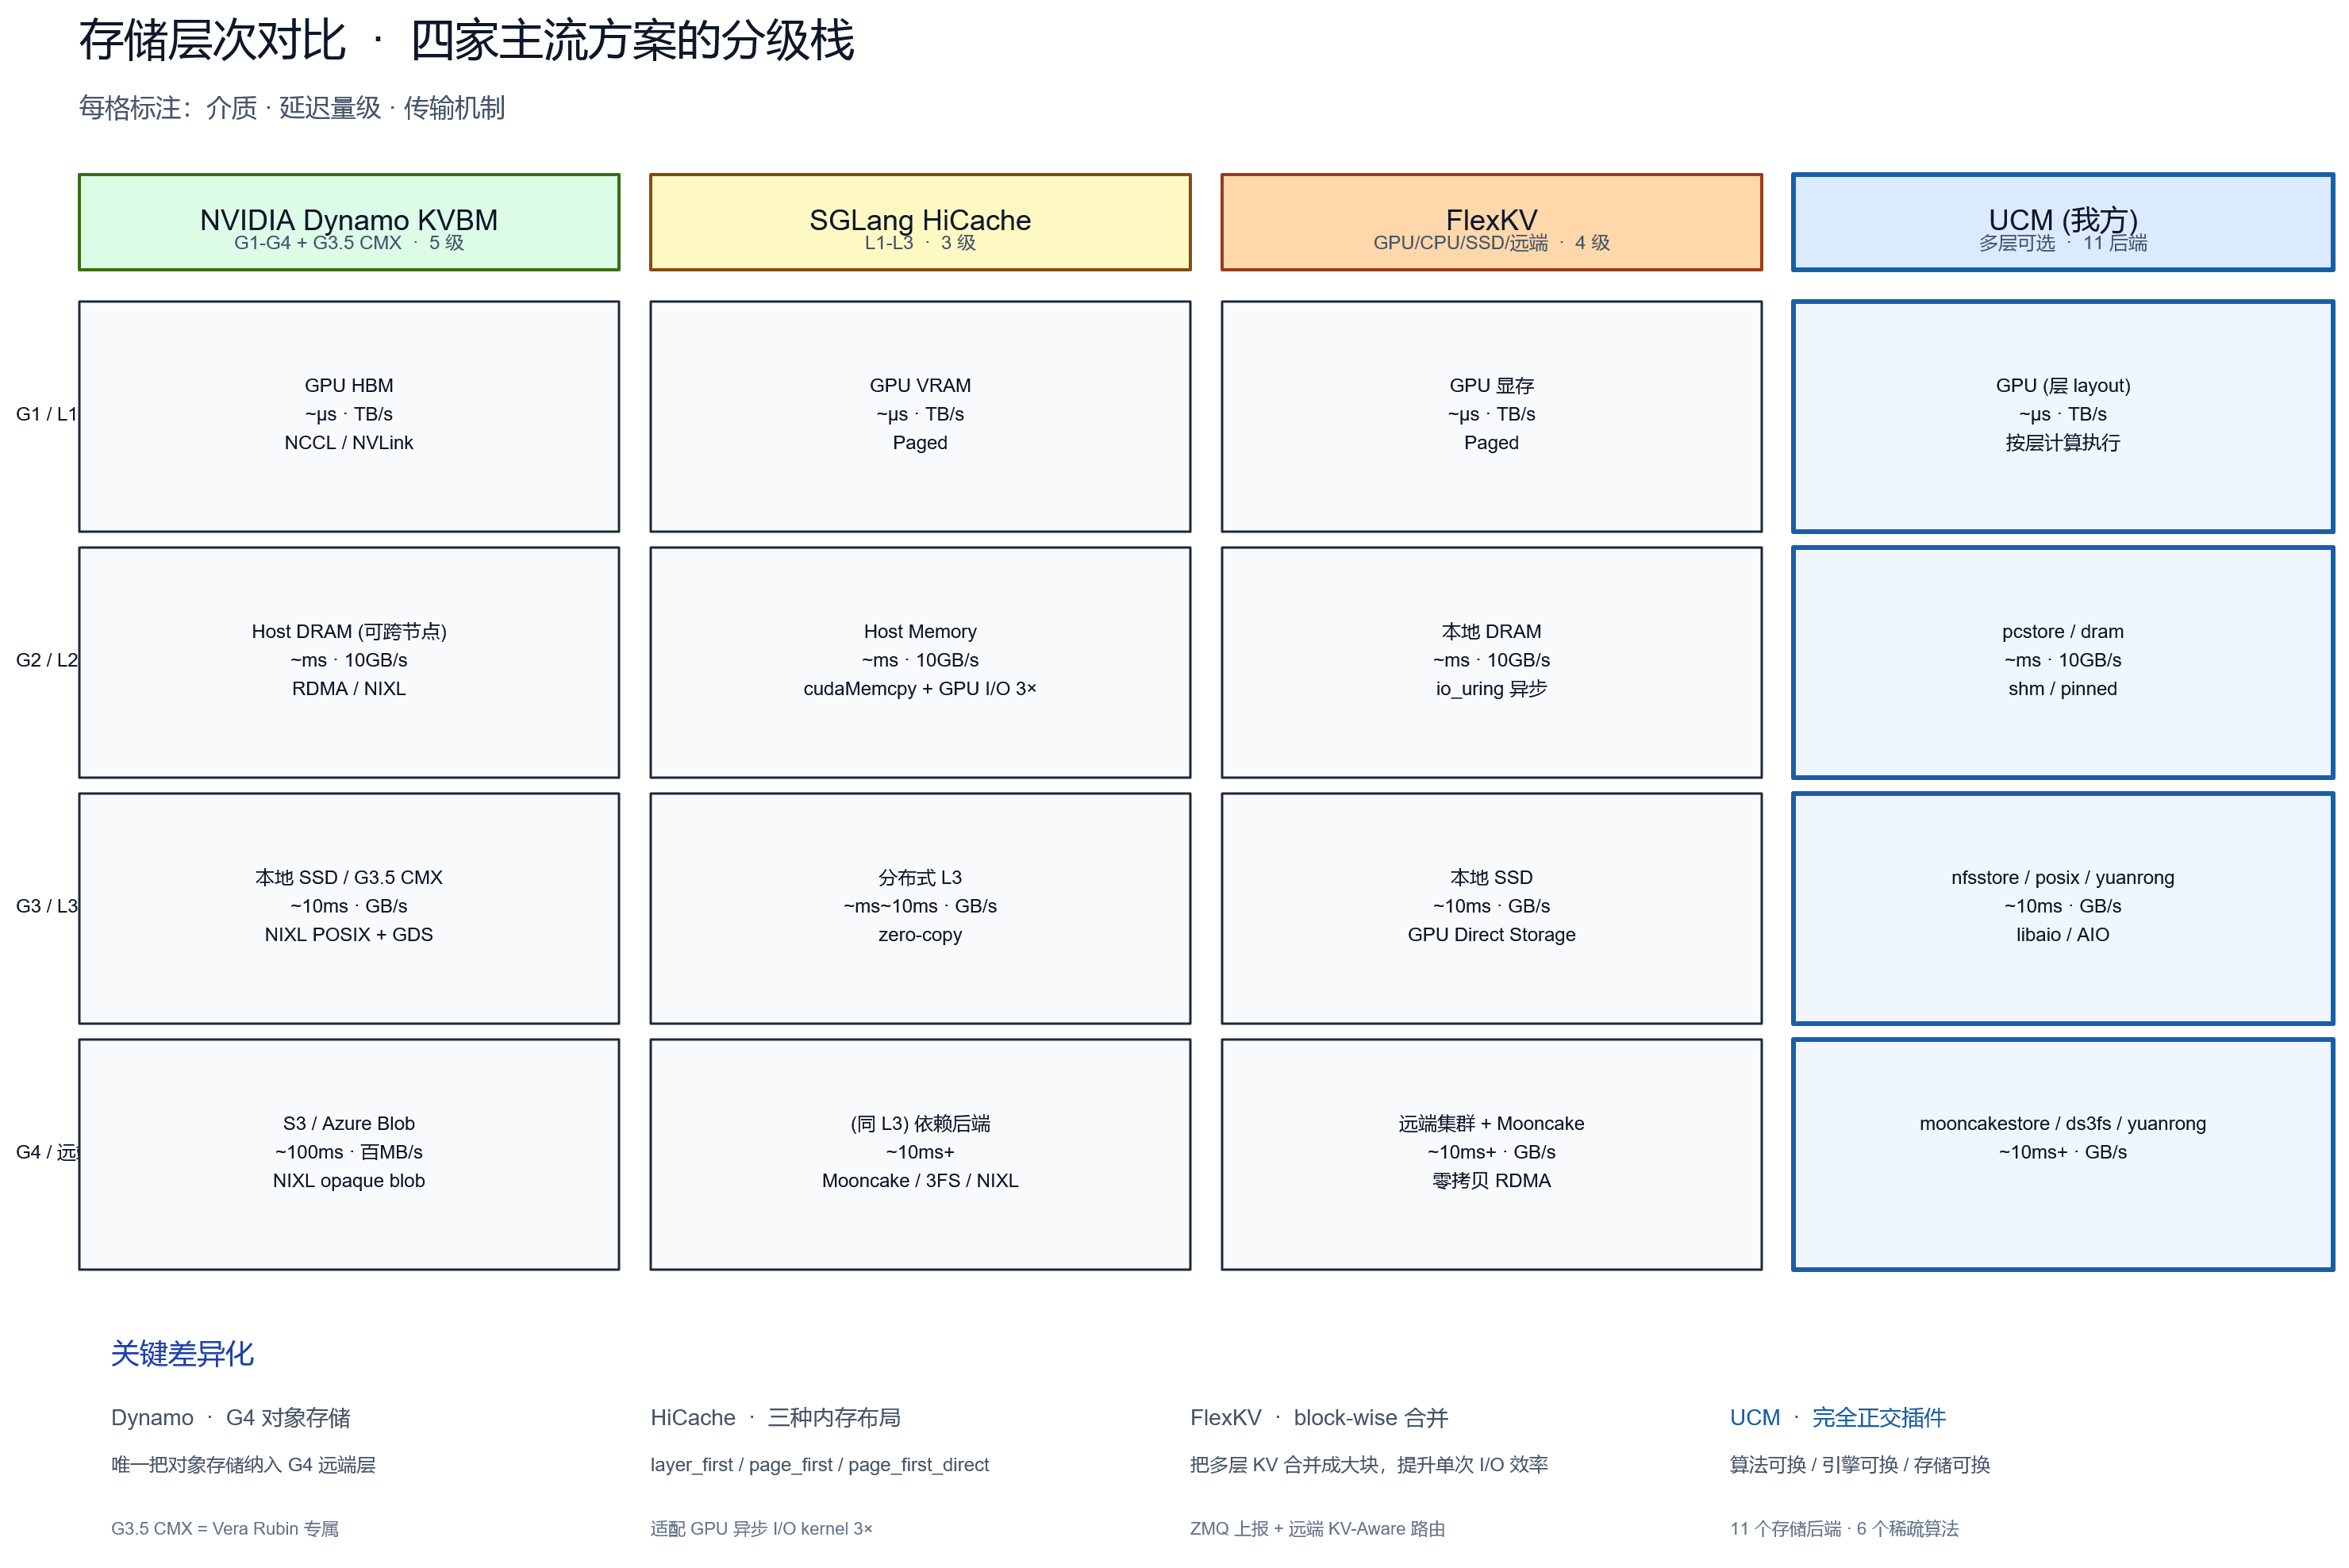
SGLang HiCache(L1 GPU / L2 Host / L3 分布式存储,HiRadixTree)、LMCache(引擎外挂 KV 层,Storage + Transport 双模式)、FlexKV(StorageEngine / GlobalCacheEngine / TransferEngine 三引擎)、NVIDIA Dynamo KVBM(G1 HBM → G2 Host DRAM → G3 本地 SSD / G3.5 CMX → G4 对象存储)。
特征:认识 KV 语义与前缀,负责命中、预取、回写、淘汰。这一层是 2026 年竞争最激烈的正面战场。
L2 · 全局元数据与管理面(Global Control Plane)
Tair KVCache Manager(中心化 Block/CacheLocation 元数据、Storage/InstanceGroup/Instance 三级抽象、配额与多租户、版本协同、ROI 评估 + HiSim 仿真)。
特征:不替代底层存储,只做 LLM 语义适配的元数据层。目前这一层只有 TairKV 一家系统化在做,也是 UCM 最该补的空位。
L3 · 集群编排与路由(Orchestration)
NVIDIA Dynamo(KV-aware router、PD 分离、GPU Planner、Grove/K8s、AIConfigurator、AIPerf)、Mooncake Conductor(Kimi 生产调度器,开源度低)、FlexKV 的 ZMQ → Dynamo KV Router 事件上报。
特征:决定“请求去哪台机器”,直接决定跨实例缓存命中率。
UCM 站哪一层?目前主体在 L1(KVStoreBase + KVStoreConnector 提供前缀缓存与卸载),但通过
UcmSparseBase向上额外占据了「算法层」这个别人没有的位置,并通过DramPool向下试探 L0。它没有占据的是 L2(全局管理面)和 L3(路由)——这正是总分被 LMCache / Dynamo / TairKV 拉开的根因。
3. 八方案画像与关键事实
3.1 UCM(我方)· 华为 ModelEngine
- 定位:推理记忆数据管理器。核心主张:持久化 KVCache,用多种检索机制替代冗余计算。
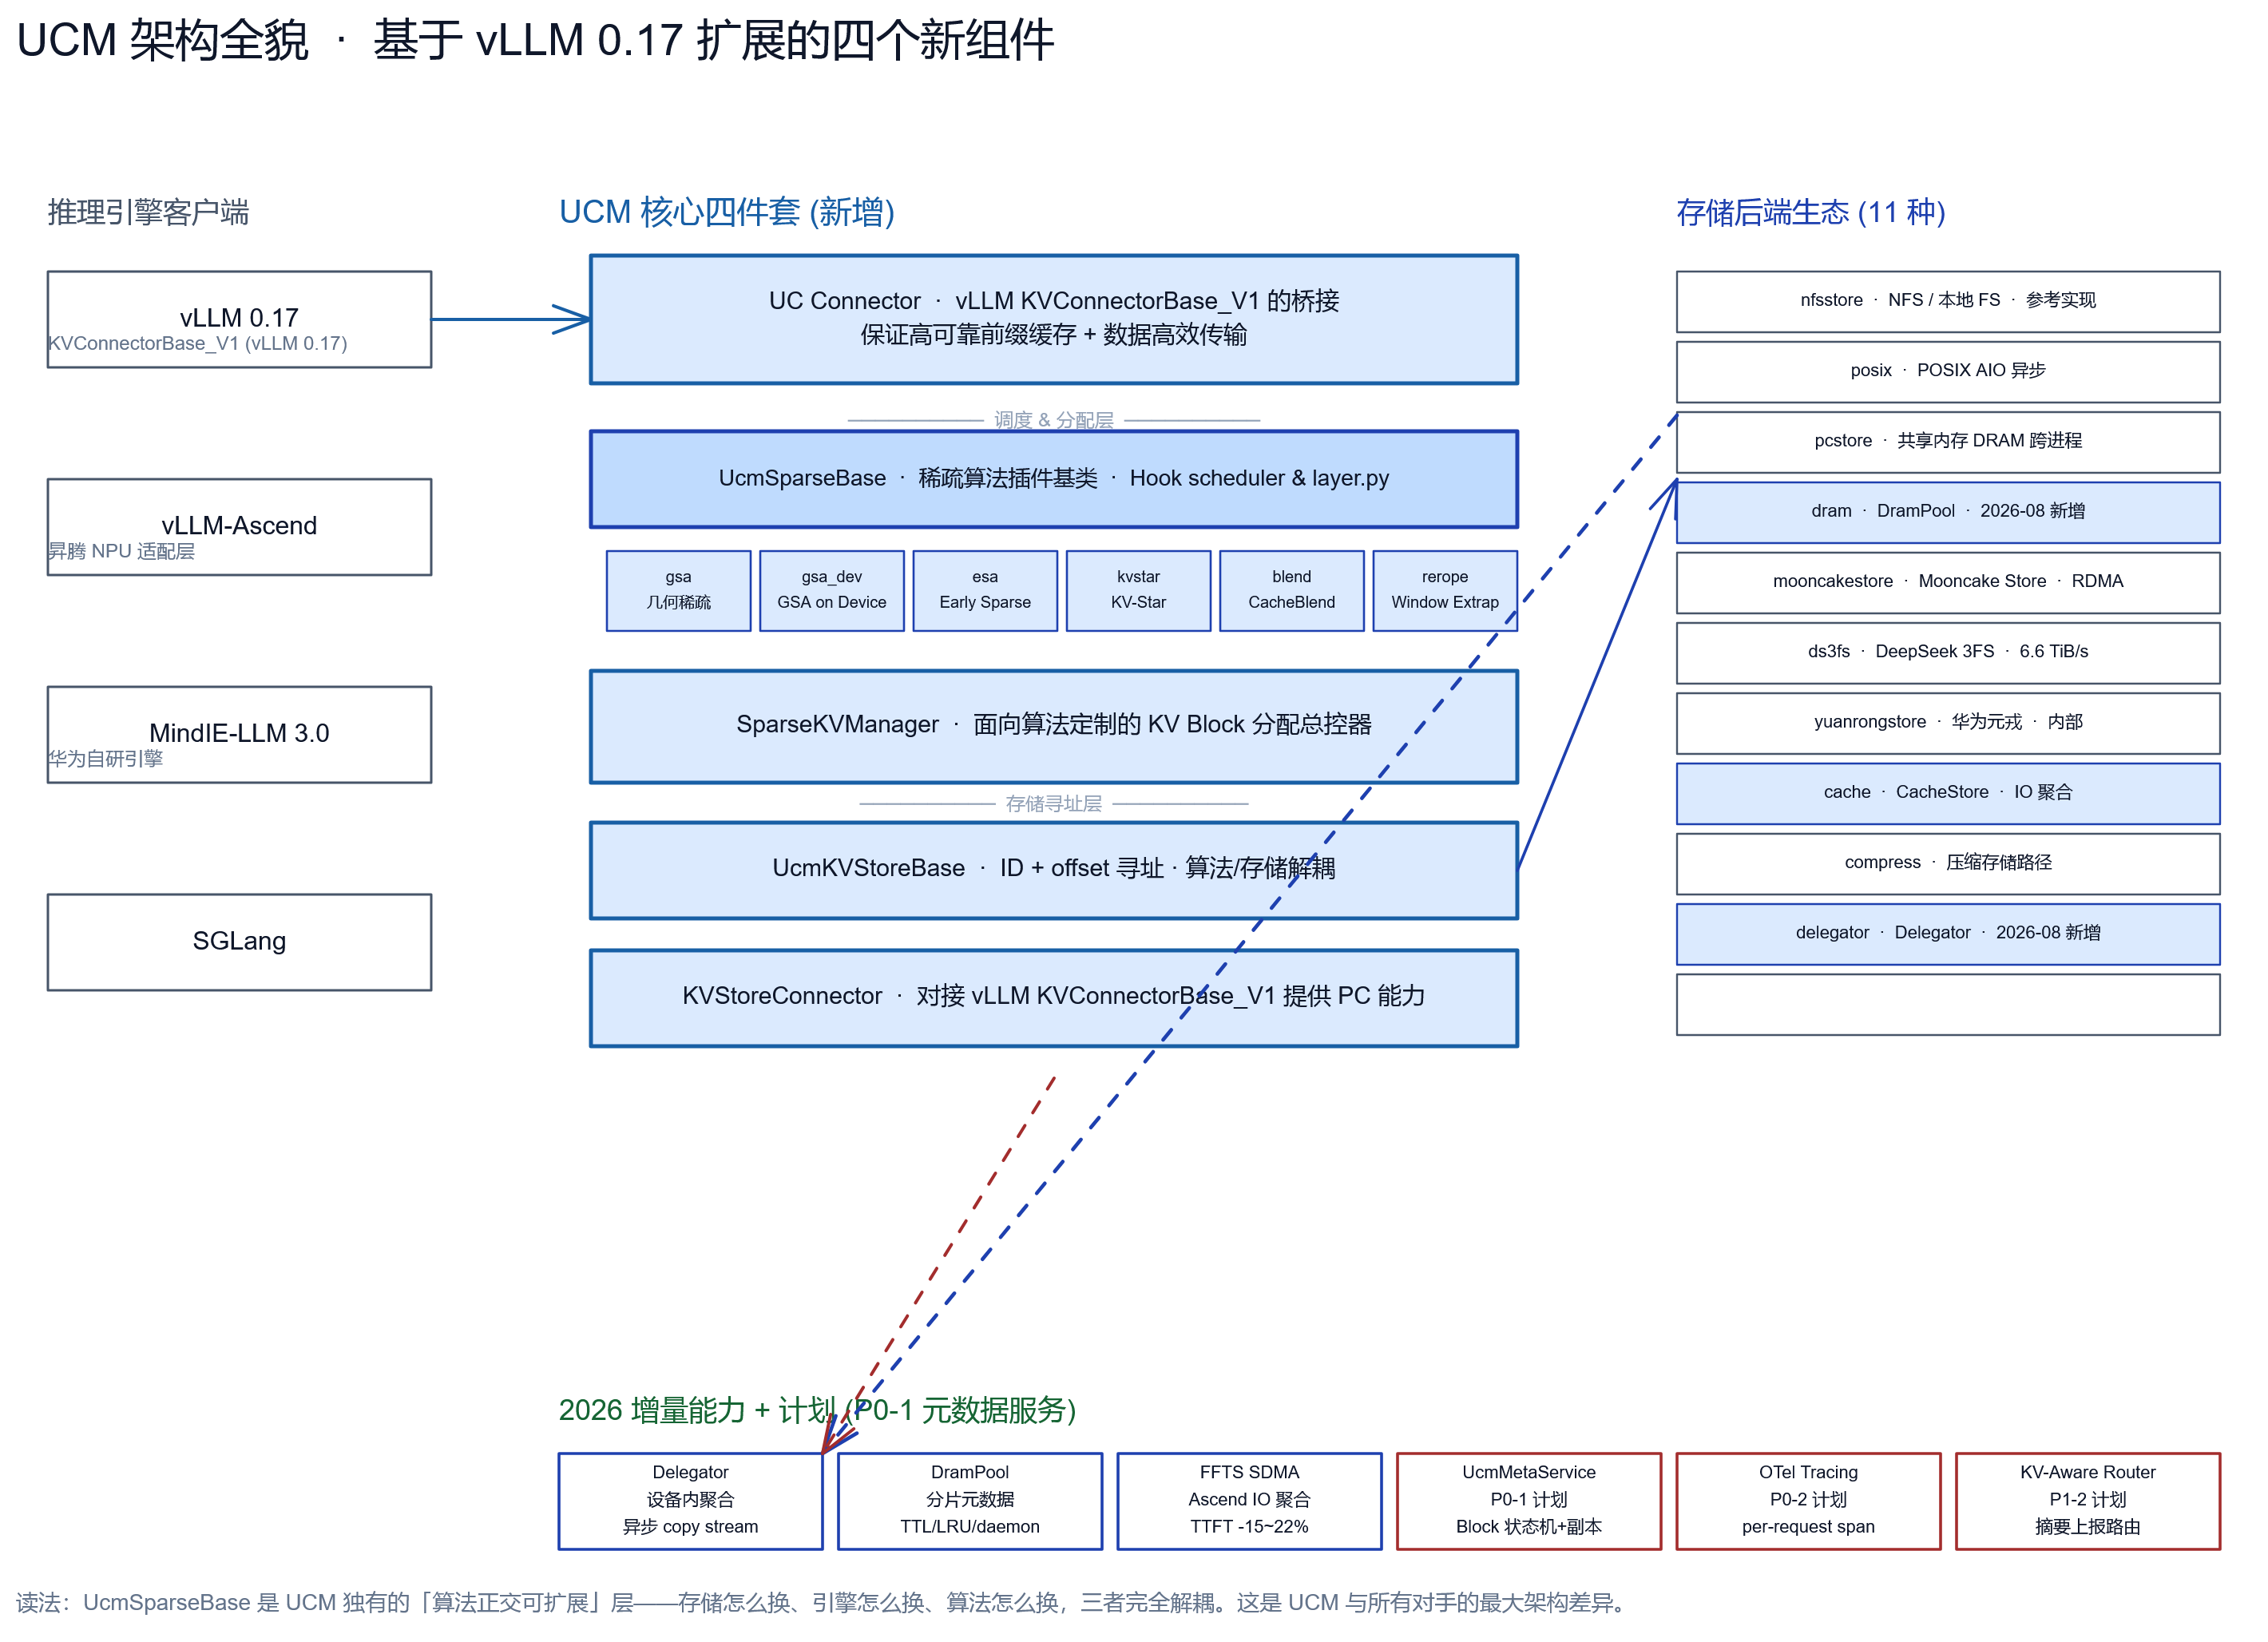
- 架构四件套:
UcmSparseBase(稀疏算法插件基类,Hook scheduler/layer.py)、SparseKVManager(块分配总控,算法与引擎解耦)、UcmKVStoreBase(ID + offset 寻址,算法与存储解耦)、UC Connector(桥接 vLLMKVConnectorBase_V1)。 - 已落地稀疏算法:
gsa、gsa_on_device、esa、kvstar、blend(CacheBlend)、rerope(仓库ucm/sparse/实测)。 - 存储后端:
nfsstore、posix、pcstore(共享内存)、dram(DramPool)、mooncakestore、ds3fs(DeepSeek 3FS)、yuanrongstore(华为元戎)、cache、compress、delegator、pipeline(pipeline的实现拆解详见 UCM Store 的 Pipeline 架构)。 - 引擎支持:vLLM(main/develop 分支对齐 v0.17.0,另维护 0.21.0 CUDA / 0.23.0 Ascend 等 Dockerfile)、vLLM-Ascend、MindIE-LLM 3.0.0 / 2.3.0、SGLang。
- 特性清单:Prefix Cache、Cache Blend、Model Window Extrapolation、Prefill Offload、Sparse Attention、Sparse Attention Offload、Heterogeneous PD Disaggregation。
- 近三个月关键提交:2026-08-31 Delegator(设备内存内 KVCache 聚合对齐后再落存储,异步 copy stream + executor);2026-08-27 DramPool(分片元数据、TTL/绝对位置/LRU、独立 daemon、HTTP 健康端点、多 HIXL 设备传输);2026-08-25 Ascend Cache IO 聚合拷贝路径(FFTS SDMA 聚合小片段,DeepSeek V4 FA 场景 TTFT 降 15.8%~21.6%);2026-08-27 指标重构(Grafana 整合为 vLLM/Connector/Store 三视图,支持 avg/p50/p90/p99)。
- 可观测:
ucm-toolkit:metrics-view(抓 Prometheus/OpenMetrics 存 SQLite,纯标准库手搓 PromQL 求值器)、nic-monitor(实时视图 + CSV + ECharts 看板)、dev-sandbox(C++17 微基准,22 用例覆盖 CE/batch-CE/SM/GDR/memcpy,支持 CUDA/Ascend/Simulation)、posix-aio。 - License:MIT with additional conditions。
GSA 算法要点(公开材料):最大范数 + SVD 联合 Block 表征 → 块级几何表征 + 稀疏卸载与预取 → 自适应稀疏/稠密与缓存复用策略切换。自适应渐进式重算:浅层重算比例高(消除 RoPE 位置编码偏差),深层递减,仅对超过阈值的 token 补算。
官方口径性能:首 Token 时延最高降 90%,TPS 提升 2–22 倍,上下文窗口 10 倍级扩展;中国银联“客户之声”试点推理速度提升 125 倍。
3.2 Mooncake · 月之暗面 + 清华 MADSys
- 定位:KVCache 为中心的分离式(disaggregated)服务架构,Kimi 的生产底座。FAST’25 最佳论文。
- 核心组件:Transfer Engine(Segment / BatchTransfer 抽象,支持 TCP、RDMA、GPUDirect、NVMe-of、CXL)+ Mooncake Store(分布式池化 KVCache,多副本抗热点、大对象条带化并行 I/O)+ P2P Store(checkpoint 分发,etcd 管元数据,纯客户端去中心化)。
- 架构:Conductor 全局调度器 + Prefill 集群 + Decode 集群 + 分布式 KVCache 池 + Messenger(RDMA)。KVCache-centric scheduler 平衡吞吐与 SLO,含基于预测的早期拒绝策略。
- 性能:TE 在 4×200 Gbps RoCE 达 87 GB/s、8×400 Gbps 达 190 GB/s(约 TCP 的 2.4× / 4.6×);vLLM 集成后 Mean TTFT 比 TCP 低 25%;长上下文场景吞吐最高 +525%,Kimi 线上多承接 75% 请求。
- 生态:vLLM 官方支持(2024-12)、SGLang(2025-04)、LMDeploy(2025-06)、NIXL backend plugin(2025-05)、LMCache remote connector(2025-04)、SGLang HiCache L3 后端、TairKV 存储后端、FlexKV 远端缓存层(2026-07)。
- 短板:强依赖 RDMA 组网,小集群性价比低;上层 Conductor 调度器开源度不足;开源侧可观测材料最少(UCM 甚至在 PR #1281 中移除了 Mooncake 独立看板)。
3.3 SGLang HiCache · LMSYS + 阿里云 Tair + Mooncake
- 定位:SGLang 原生的三级分层 KVCache,把 RadixAttention 从显存扩展到 Host 内存与分布式存储。
- 架构:HiRadixTree(节点记录 KV 存在于 L1/L2/L3 的哪几层;L1/L2 维护精确地址,L3 实时查后端不缓存元数据)+ Cache Controller(local match → prefetch → write-back 三阶段)+ HiCacheStorage ABC。
- 接入成本:新后端只需实现
get(key)/exist(key)/set(key, value)三个方法,调度与同步由中央控制器统一处理。 - 已集成后端:Mooncake、DeepSeek 3FS(HF3FS)、NIXL、AIBrix KVCache、HiCacheFile(参考实现)。
- 策略丰富度:预取三策略(best_effort / wait_complete / timeout,timeout 默认 base 2s + 0.1s/千 token,上限 30s);回写三策略(write_through / write_through_selective / write_back)。
- I/O 优化:GPU-assisted I/O kernel(较 cudaMemcpyAsync 最高 3× 吞吐);内存布局 layer_first / page_first / page_first_direct;零拷贝;逐层计算-传输重叠;TP 下 MLA 模型仅单个 rank 回写避免冗余。
- 实测:Novita AI(Qwen3-Coder-480B 编程 Agent):命中率 40%→80%,平均 TTFT −56%,QPS ×2;蚂蚁集团(DeepSeek-R1-671B PD 分离):命中时 TTFT 降 84%;官方基准:最高 6× 吞吐、TTFT 最高降 80%。
- 短板:控制器在引擎进程内,无独立管理面与全局元数据服务,跨实例共享完全依赖 L3 后端;无独立可观测栈(社区明确列为待贡献方向)。
3.4 LMCache · LMCache Lab / TensorMesh(源自 UC Berkeley)
- 定位:“AI Memory Tensor”——让 KV cache 成为可存储、压缩、检索、复用的 AI 原生内存。
- 双模式:Storage 模式(DB 风格卸载,跨请求/跨会话持久化,进程重启后缓存存活);Transport 模式(P2P 实时传输,PD 分离,走 NIXL)。
- 部署形态:In-Process / Multiprocess(推荐,未来主路径)——独立
lmcache server进程,与推理引擎进程隔离。 - 六大能力:Store / Reuse / Search(CacheBlend,超越精确前缀匹配)/ Compress(CacheGen)/ Move / Observe。
- Controller API:Lookup、Clear、Compress/Decompress、Move(缓存预热/迁移)、Pin/Unpin(防驱逐)、Health & Finish Checks。
- 可观测(全场最强):OTel 三件套 + 内部 EventBus 解耦(队列 10000 尾丢弃):metrics(Prometheus
/metrics默认 9090,lmcache_mp.*前缀,L1 读写/驱逐/chunk 生命周期直方图,默认 1% 采样)、logging(可选 OTel 转发)、tracing(OTLP gRPC,per-request root span 带hit_tokens/requested_tokens/hit_rate属性;子 spanmp.lookup_prefetch/mp.retrieve/mp.store;CacheBlend 独立cb.*span 树)。官方提供 Prometheus + Tempo + Grafana docker-compose 一键示例。--trace-level storage支持离线回放。 - 生态:vLLM(connector 已合入上游)、SGLang(
--enable-lmcache)、TRT-LLM(coming);NVIDIA Dynamo 官方集成、Google Cloud GKE、AMD MI300X(3–10×)、CoreWeave AI Object Storage、Redis、PyTorch Foundation 认可。 - 短板:自身不实现前缀匹配逻辑,前缀复用依赖上层引擎;无全局元数据服务(MP 模式靠 controller 协调);压缩/量化为有损路径需业务侧接受(与 UCM 的接口兼容性详见 极致性能 vs 极致兼容:UCM 与 LMCache 的两种形状)。
3.5 MemCache · 华为昇腾 MindCluster(+ MemFabric)
- 定位:不是 KVCache 卸载方案,而是超节点内存语义池化底座。提供分布式内存池化 + 对象缓存(Put/Get),可应用于 KVCache 缓存池等场景。
- 核心创新:GVA 全局虚拟地址统一编址(
xcopy with global virtual address,接口贴近memcpy)。所有进程共享相同起始地址、线性排布的 uint64 地址空间,跨节点跨介质(CPU 内存 / NPU 显存)直接访问,无需数据中转、无控制面消息。 - 分层:上层 MemCache(对象 Put/Get 语义,池化应用层)→ 下层 MemFabric(统一编址内存语义,池化基础能力;南向插件化支持 MTE/SDMA/UDMA 与 Device UB / Device RoCE / Host UB / Host RoCE)。
- 实测(昇腾 A3 超节点):最大 128TB CPU 内存 + 48TB NPU 显存混合池;对比非内存语义方案,时延随规模线性增长且明显更低;单 die 跨机带宽 RH2LD 102.7 GB/s、LD2RH 69.4 GB/s、LD2RD 128.5 GB/s、RD2LD 155.0 GB/s;对接 Mooncake TE 对比测试中内存语义方案占优。
- KVCache 场景实测:4 节点 2P1D,DeepSeek-R1,每台贡献 640GB CPU 内存组成 2.5TB KVPool(水位 85%,超限淘汰 5%),4K 输入 + 1 输出 token、400 组前缀 × 25 请求:内存语义 KVPool 相比无 KVPool baseline 与消息语义方案均有明显吞吐提升。
- 短板:只提供池化与对象语义,不含前缀匹配、稀疏化、淘汰策略族、管理面;仅支持昇腾/鲲鹏,开源建设早期(gitcode.com/Ascend/memcache)。
关键判断:把 MemCache 放进“竞品清单”会误导决策。它与 UCM 是同厂垂直互补——MemCache 解决“跨机跨介质的字节怎么搬得快”,UCM 解决“搬什么、什么时候搬、搬回来怎么算”。在昇腾超节点上应打包对外;在 NVIDIA 生态里它才是对标 Mooncake Store / NIXL 的替代件。
3.6 NVIDIA Dynamo(含 KVBM)
- 定位:数据中心级分布式推理服务框架 + KV Block Manager(KVBM)。Dynamo 1.0 于 2026-03-16 GA。
- KVBM 三层:模型集成层(connector 适配 vLLM / TensorRT-LLM,SGLang 在路上,无需逐模型集成)→ 内存管理层(KvBlockManager / Scheduler / TransferManager / LayoutConfig,管理分配、布局、生命周期、复用与淘汰)→ NIXL 传输层(P2P GPU、RDMA、NVLink 远程内存共享、动态块注册与元数据交换、存储后端插件接口)。
- G1–G4 四级缓存:G1 GPU HBM(µs 级)G2 Host DRAM,可跨节点分布(ms 级)G3 本地/池化 NVMe;G3.5 CMX / Context Memory Storage,Vera Rubin 平台的以太网挂载 pod 级闪存层(
10 ms)G4 对象存储 S3 / Azure Blob(数十百 ms)。迁移策略由块的复用频率驱动。 - 拓扑配置:GPU→CPU;GPU→CPU→Disk;GPU→Disk(实验性)。
- 关键参数:
DYN_KVBM_CPU_CACHE_GB(建议 ≥100,且必须 > GPU KV cache,否则每次 forward 都触发卸载导致 churn)、DYN_KVBM_DISK_CACHE_GB、DYN_KVBM_OBJECT_*(S3)、leader/worker ZMQ 分布式模式 + etcd 注册发现。 - 外围能力:KV-aware router(缓存感知路由)、PD 分离、Grove(K8s 拓扑感知编排)、GPU Planner(动态分配 prefill/decode 节点)、NIXL、AIConfigurator(按模型/GPU 预算/SLO 推荐配置)、AIPerf(基准测试)。
- 可观测:Prometheus + Grafana;KVBM worker 指标端口 6880、leader 6881;
DYN_SYSTEM_ENABLED=true开启。 - 第三方验证:IBM Redbook(Dynamo + IBM Storage Scale ECE + Supermicro + Spectrum-X):130K token 输入 TTFT 提速 56×;并发吞吐 0.19 → 4.26 RPS(22×);200GB/s 网络噪声下仍 3.6 RPS(18×,仅降 18%)。Vast:单 H100 上 GDS 插件 35 GB/s。WEKA:8×H100 上 270 GB/s 读取。
- 短板:G1–G3.5 均绑定单机硬件,无跨节点 HA(IBM 白皮书明确指出);强绑 NVIDIA 全栈;SGLang connector 尚未落地。
3.7 TairKV(Tair KVCache Manager)· 阿里云
- 定位:企业级全局 KVCache 元数据管理服务。不替代底层存储,只做 LLM 语义适配与元数据管理,向下映射到 NFS / 3FS / TairMemPool / Mooncake 等既有存储。
- 设计动机:现有存储接口面向通用场景,抹掉了 LLM 语义:① 数据间有前缀依赖性(A,C 与 B,C 中的 C 不同);② 查询模式是“前缀匹配 + 反向滑动窗口(SWA/Linear)”;③ 单 block 内切分模式多样(并行策略 + 混合注意力);④ TP/PP 下多进程同读同写同一 block 的不同 head,生命周期绑定、缺一不可。直接套通用 KV 接口会导致“部分 Key 被逐出 → 剩余 Key 占容量但无法命中”的浪费。
- 管控面抽象:Storage(一套存储系统,支持多种类型,可被多个 Instance Group 共享)→ Instance Group(共享配额,可单独配置可用 Storage 列表;对应一个业务团队 / 一个模型的多版本 / 独占资源的重要模型 / 共享长尾模型)→ Instance(KVCache 实例,模型与 fp8/bf16、block_size 等配置唯一且不变;仅 Instance 内部复用)。
- 数据面抽象:Block(定长连续 token,有前缀依赖;可有多个 CacheLocation)→ CacheLocation(单个存储位置,状态机 writing → serving → deleting)。
- 企业级能力:容量精准评估与 ROI 筛选、动态弹性伸缩、多租户隔离、配额管理、高可用保障、模型版本隔离与灰度容量柔性调整、可观测水位感知。
- 配套工具:Tair KVCache HiSim:首个高保真推理仿真器,普通 CPU 服务器即可预测端到端性能,联合 NVIDIA Dynamo AIConfigurator 在“时延-吞吐-成本”三角约束下自动搜索最优配置,宣称 39 万倍成本优势。
- 生态:支撑阿里集团 RTP-LLM,扩展到 vLLM / SGLang / TensorRT-LLM;兼容 Sparse Attention、Sliding Window Attention 等多种注意力机制;深度集成 Mooncake;对接 Dynamo AIConfigurator。已开源(github.com/alibaba/tair-kvcache)+ 商业版全托管。
- 短板:强绑阿里云商业版才能拿到全托管与 SLA;数据面能力依赖外部存储系统,自身不提供存储;社区影响力主要在阿里生态内。
3.8 FlexKV · 腾讯云 TACO
- 定位:面向超大规模 LLM 推理的分布式 KV Store + 多级缓存管理系统,打通推理引擎到云存储的桥梁。2025-10 于腾讯全球数字生态大会宣布开源。
- 三引擎:StorageEngine(三级缓存初始化与管理,保持与 GPU 内 KV shape 完全一致,block ID 快速算物理偏移;block-wise 模式合并多层 KV 成大粒度 block 提升 I/O 效率);GlobalCacheEngine(决策调度路径与源/目标 block ID 映射,RadixTree 前缀匹配 + mempool + LRU 淘汰);TransferEngine(多进程 + 多线程,io_uring、异步 I/O、GPU Direct Storage)。
- 核心差异化:① 分布式 RadixTree 前缀索引——首创,规避中心化索引的单点性能/延迟/故障风险;② KV-Aware 智能路由——通过 ZMQ 事件机制把本地缓存状态实时上报 Dynamo KV Router,路由器基于全局 RadixTree 视图把请求调度到命中率最高的 Worker;③ 异步流水线让 Store/Retrieve 与 GPU 计算完全重叠。
- 生态合入节奏(2026 最大跃迁):2026-03-03 / 03-12 / 03-28 分别合入 NVIDIA Dynamo、vLLM(PR #34328,v0.17.2 起内置 FlexKVConnectorV1)、TensorRT-LLM 官方主分支;2026-07-07 FlexKV Connector 合入 SGLang 主干(PR #29701)。
- 近期迭代:2026-07-21 完成 DeepSeek-V4 适配(异构 C4/C128/indexer KV group、FullKV + SWA 双缓存、attention/indexer compress-state sidecar、逐层恢复);2026-07-24 支持 Mooncake Store 作为 Key 型远端缓存层(零拷贝 RDMA);2026-07-07 Blackwell 上 NVFP4 KV Cache 字节级无损卸载与恢复;2026 年 7–8 月 GPU↔CPU 自适应多路径传输、可靠性与日志增强、优雅退出、分块注册 Host Memory、SSD 向量化 I/O、Op 级传输 Trace。
- 可观测:零侵入 Prometheus 运行时监控框架(缓存命中/未命中率、内存状态、传输统计)。
- 实测:Phison(群联):产品说明增强搜索 TTFT −70%,医疗问答助手对话时延 −57%;腾讯云:TTFT −60%,TPOT −13%,单集群 QPM +16%。
- License:Apache-2.0。
- 短板:开源时间最短(2025-10),生产验证规模与时长仍不及 Mooncake / LMCache;无独立全局管理面(多租户、配额、版本协同);无稀疏化算法能力。
4. 六维评分矩阵
评分标准:每项 1–5 分,5 分为该维度当前业界最优。评分依据见第 5 节逐项拆解与第 13 节证据表。
| 方案 | 架构解耦 | 特性完备 | 可靠性 / HA | 可观测性 | 生态集成 | 可演进性 | 总分 /30 |
|---|---|---|---|---|---|---|---|
| LMCache | 4 | 4.5 | 4 | 5 | 5 | 4.5 | 27.0 |
| NVIDIA Dynamo | 4.5 | 4.5 | 4 | 4 | 4.5 | 5 | 26.5 |
| TairKV | 4.5 | 4 | 5 | 4.5 | 3.5 | 4.5 | 26.0 |
UCM(我方) 我方 |
5 | 5 | 3 | 3.5 | 3 | 5 | 24.5 |
| FlexKV | 4 | 4 | 3.5 | 3.5 | 4.5 | 4.5 | 24.0 |
| Mooncake | 5 | 3.5 | 4.5 | 2.5 | 5 | 3.5 | 24.0 |
| SGLang HiCache | 4 | 3.5 | 3.5 | 3 | 4.5 | 4 | 22.5 |
| MemCache | 4.5 | 2.5 | 4 | 2.5 | 2.5 | 3.5 | 19.5 |
怎么读这张表。MemCache 分数低不是因为它弱,而是因为它只覆盖 L0 一层,功能面天然窄——把它和完整 KVCache 方案比总分不公平。同样,Mooncake 的“特性完备 3.5 / 可观测 2.5”是因为开源部分聚焦在 TE + Store,而非全线能力。总分衡量的是”作为独立产品交付时的完整度”,不是技术深度。
5. 分维度深挖
5.1 架构解耦
UCM 与 Mooncake 并列第一(5 分),但解耦的方向不同。
- Mooncake 解耦的是介质与网络:
Segment(RAM / NVMe-of)+BatchTransfer两个抽象就把 DRAM、VRAM、远程 DRAM、远程 VRAM、远程 NVMe 五种路径统一了。这是它成为事实标准的原因——抽象足够小,谁都能接。 - UCM 解耦的是算法与存储:
UcmSparseBase让任意稀疏算法像 KV connector 一样插拔,KVStoreBase用 ID + offset 寻址(天然同时适配稀疏与前缀缓存),SparseKVManager让算法自定义块分配。这是全场唯一把“用什么算法算”和“数据存在哪”做成两个正交可扩展维度的架构。 - MemCache 的 GVA 统一编址(4.5 分)在抽象优雅度上其实最高——
memcpy(dest, src, n)语义屏蔽了节点与介质差异,把控制面消息完全消灭。但它是底座抽象,不构成完整方案。 - TairKV(4.5 分)解耦的是管理面与数据面,Block/CacheLocation 两层抽象把 LLM 语义(前缀依赖、多进程同写同 block、生命周期绑定)从通用 KV 接口里救了回来。
- Dynamo KVBM(4.5 分)用 connector 层屏蔽引擎差异,用 NIXL 插件屏蔽存储差异,是“横向解耦”最彻底的,但纵向绑定 NVIDIA 栈。
- HiCache(4 分)的
HiCacheStorageABC 只要 3 个方法,接入成本最低,但控制器在引擎进程内,是“引擎内解耦”而非“系统级解耦”。
5.2 特性完备度
| 能力 | UCM | Mooncake | HiCache | LMCache | MemCache | Dynamo | TairKV | FlexKV |
|---|---|---|---|---|---|---|---|---|
| 前缀缓存 | ● | ● | ● | ● | ○ | ● | ● | ● |
| 多级卸载(≥3 级) | ● | ● | ● | ● | ○ | ● | ● | ● |
| 对象存储 / 远端持久化 | ◐ | ◐ | ● | ● | ○ | ● | ● | ● |
| PD 分离 | ● | ● | ● | ● | ○ | ● | ◐ | ● |
| KV 感知路由 | ○ | ◐ | ○ | ◐ | ○ | ● | ◐ | ● |
| 稀疏注意力算法 | ●(6 种) | ○ | ○ | ○ | ○ | ○ | ◐ | ○ |
| KV 压缩 / 量化 | ◐ | ○ | ○ | ● | ○ | ◐ | ○ | ◐ |
| 非前缀复用(CacheBlend) | ● | ○ | ○ | ● | ○ | ○ | ○ | ○ |
| 模型窗口外推 | ● | ○ | ○ | ○ | ○ | ○ | ○ | ○ |
| 多租户 / 配额 | ○ | ○ | ○ | ◐ | ○ | ◐ | ● | ○ |
| 容量 ROI / 仿真 | ○ | ○ | ○ | ○ | ○ | ◐ | ● | ○ |
| 集群编排 / 调度 | ○ | ◐ | ○ | ○ | ○ | ● | ◐ | ◐ |
● 明确支持并有文档/代码 · ◐ 部分支持或依赖外部组件 · ○ 未见公开支持
结论:UCM 是唯一在“稀疏注意力”和“模型窗口外推”上有实装方案的产品,这两项构成了它的独占区。但在管理面(多租户/配额/ROI)和编排面(KV 感知路由/集群调度)上是完全空白——这正是总分被扣掉的 2 分。
5.3 可靠性 / 高可用
- TairKV · 5 分:唯一把 HA 写进设计目标(中心化元数据高可用、多租户隔离、配额、模型版本隔离与灰度容量迁移;阿里集团 PB 级生产验证。)
- Mooncake · 4.5 分:Kimi 大规模生产验证(TE 传输失败自动切换备选路径;Store 多副本缓解热点;预测式早期拒绝防雪崩。)
- UCM · 3 分:有工程细节,无集群 HA(DramPool 有 TTL/租约/健康端点,PCStore 修了 shm 残留,Delegator 异步化——但都是节点内可靠性,无跨实例故障域设计。)
UCM 具体缺什么:
- 缺全局元数据服务。TairKV 的 Block/CacheLocation 状态机(writing → serving → deleting)解决的是“部分写入的数据不能被读到”这个分布式经典问题。UCM 的
KVStoreBase是单机视角的 ID+offset 寻址,多实例并发写同一 block 时的一致性语义未在公开材料中定义。 - 缺副本与故障域。Mooncake Store 有多副本抗热点,Dynamo G4 落到 S3 天然多 AZ。UCM 的持久化落在 NFS/3FS/元戎,可靠性完全外包给后端,自身没有副本策略。
- 缺降级路径。当存储后端不可用时,是降级为本地重算、还是拒绝请求?HiCache 的
best_effort预取策略给出了一种答案(GPU 可执行 prefill 时立即终止预取),UCM 的公开文档未见对应设计。 - 缺公开 SLA 案例。中国银联试点是唯一公开的规模化验证,但没有常态化生产的可用性数据。相比之下 Mooncake(Kimi 日活)、TairKV(阿里集团 RTP-LLM)、Dynamo(IBM/Supermicro 三方 Redbook)都有持续生产佐证。
5.4 可观测性
LMCache 断档第一(5 分)。它是唯一把 metrics / logging / tracing 三件套做成标准化 OTel 管道、并提供 request 级 span 树的方案:
- per-request root span 携带
hit_tokens/requested_tokens/hit_rate,可直接按hit_rate < 0.5或hit_tokens = 0在 Tempo 里筛出“缓存没起作用”的请求; - 子 span 拆到
mp.lookup_prefetch/mp.retrieve/mp.store,CacheBlend 再发独立cb.request→cb.lookup/cb.fingerprint_match/cb.sparse_prefetch/cb.scatter树; --trace-level storage可录StorageManager公共 API 调用做离线回放——这对复现线上问题极有价值;- EventBus 解耦生产者与订阅者,队列满时尾丢弃,观测本身不会拖垮主链路。
UCM 得 3.5 分的理由与差距:
- 做得好
dev-sandbox是全场独一份的能力——22 个微基准用例覆盖设备/主机拷贝路径(CE / batch-CE / SM / GDR / memcpy,同卡跨卡)、主机设备传输矩阵、AIO 磁盘带宽,支持 CUDA / Ascend / Simulation 三后端,CUDA 下通过 libibverbs 支持 GDR。这是定位“IO 为什么慢”的利器,LMCache / HiCache 都没有对等物。 - 做得好 Grafana 已整合为 vLLM / Connector / Store 三类视图,支持 avg / p50 / p90 / p99 延迟对比,且能按文档公式算分层命中率与聚合带宽。
- 差距 没有 tracing。只有 Prometheus counter/gauge,没有 request 级 span。线上出现“某批请求 TTFT 突然变高”时,无法下钻到具体请求的 lookup/retrieve/store 分解。
- 差距
metrics-view走 SQLite + 自研 PromQL 求值器,是“自研管道”而非标准 OTel。好处是零依赖,坏处是无法接入企业已有的 Grafana / Tempo / Jaeger 体系,运维侧要单独学一套。 - 差距 未提供开箱即用的 docker-compose 观测栈示例(LMCache 有 Prometheus + Tempo + Grafana 一键起)。
5.5 生态集成
2026 年这个维度发生了位次变化。
| 方案 | 主干合入 | 引擎覆盖 | 厂商/云背书 | 生态位判断 |
|---|---|---|---|---|
| Mooncake | vLLM、SGLang、LMDeploy;NIXL backend plugin | vLLM / SGLang / LMDeploy | Moonshot AI、清华 MADSys | 事实标准传输层,被几乎所有对手引用 |
| LMCache | vLLM 上游 connector 合入 | vLLM / SGLang / TRT-LLM(coming) | NVIDIA、Google GKE、AMD、CoreWeave、Redis、PyTorch Foundation | 中立层的事实标准,跨 GPU 厂商最广 |
| FlexKV | vLLM #34328、Dynamo、TRT-LLM、SGLang #29701 | 四框架全覆盖 | 腾讯云 TACO、Phison | 2026 年合入速度最快,一年追平 |
| Dynamo | 自有框架 | vLLM / TRT-LLM / SGLang(在路上) | NVIDIA 全栈 + IBM、Supermicro、Vast、WEKA | NVIDIA 生态默认选项 |
| HiCache | SGLang 原生 | SGLang(+ LMCache 旁路) | 阿里云 Tair、Novita AI、蚂蚁集团、AIBrix | SGLang 用户零成本默认选择 |
| TairKV | 独立服务 | RTP-LLM / vLLM / SGLang / TRT-LLM | 阿里云、Dynamo AIConfigurator | 阿里生态 + 管理面标准候选 |
| UCM | 无主干合入(走 vLLM KVConnector 接口,技术上不需要) | vLLM / vLLM-Ascend / MindIE-LLM / SGLang | 华为、ModelEngine / GitCode 社区、中国银联 | 昇腾生态默认,CUDA 侧存在感弱 |
| MemCache | vLLM-Ascend 场景验证 | vLLM-Ascend | 华为昇腾 MindCluster | 仅昇腾,开源建设早期 |
P0 这条要正视。技术上看,UCM 走 vLLM 的
KVConnectorBase_V1标准接口,不需要合入主干就能工作——合入与否不影响功能。但”官方主分支收录“是一种心智占位和信任背书:FlexKV 在 vLLM release note 里出现,用户在选型清单上就会看到它;UCM 需要用户主动去 ModelEngine / GitCode 找。在采购决策链上,这是实打实的差距。
5.6 可演进性
UCM 与 Dynamo 并列 5 分。
- UCM(5 分):架构本身就是为演进设计的——
StoreV1接口重构(PR #518)、DramPool(#1284)、Delegator(#1300)都是在不破坏上层抽象的前提下做替换;稀疏算法框架意味着新算法只需新增SparseKVBase子类;已适配 DeepSeek V4 的 FAWA 异构 KV(Full Attention / Window Attention 双路径 + compress-state sidecar);同时支持 CUDA 与 Ascend 双平台(含 Simulation 后端用于无硬件测试);路线图公开在 Issue #679(接口契约的完整拆解详见 UCM v2 接口设计,这条演进路径的 commit 史还原见 UCM 演进之路)。 - Dynamo(5 分):G4 对象存储、CMX(G3.5) 已规划进 Vera Rubin 平台;SGLang connector 在路上;AIConfigurator + GPU Planner 向“自动驾驶式容量规划”演进。
- TairKV(4.5 分):七篇系列技术文章构成清晰路线图(混合架构模型支持 → 分层稀疏注意力 → 软硬结合),明确定位为“为专用存储系统探明需求与接口边界”的过渡层。
- FlexKV(4.5 分):迭代速度最快(DeepSeek-V4、NVFP4、Mooncake 后端、SGLang 合入集中在 2 个月内);路线图明确(框架深度适配、分布式查询、压缩与智能调度、GooseFS 接入)。
- Mooncake(3.5 分):TE 已稳定但演进趋缓;Store 与 LMCache 合作;Conductor 调度器开源度不足是长期隐忧。
6. 数据平面细节:Block 粒度、内存布局、传输路径、预取回写
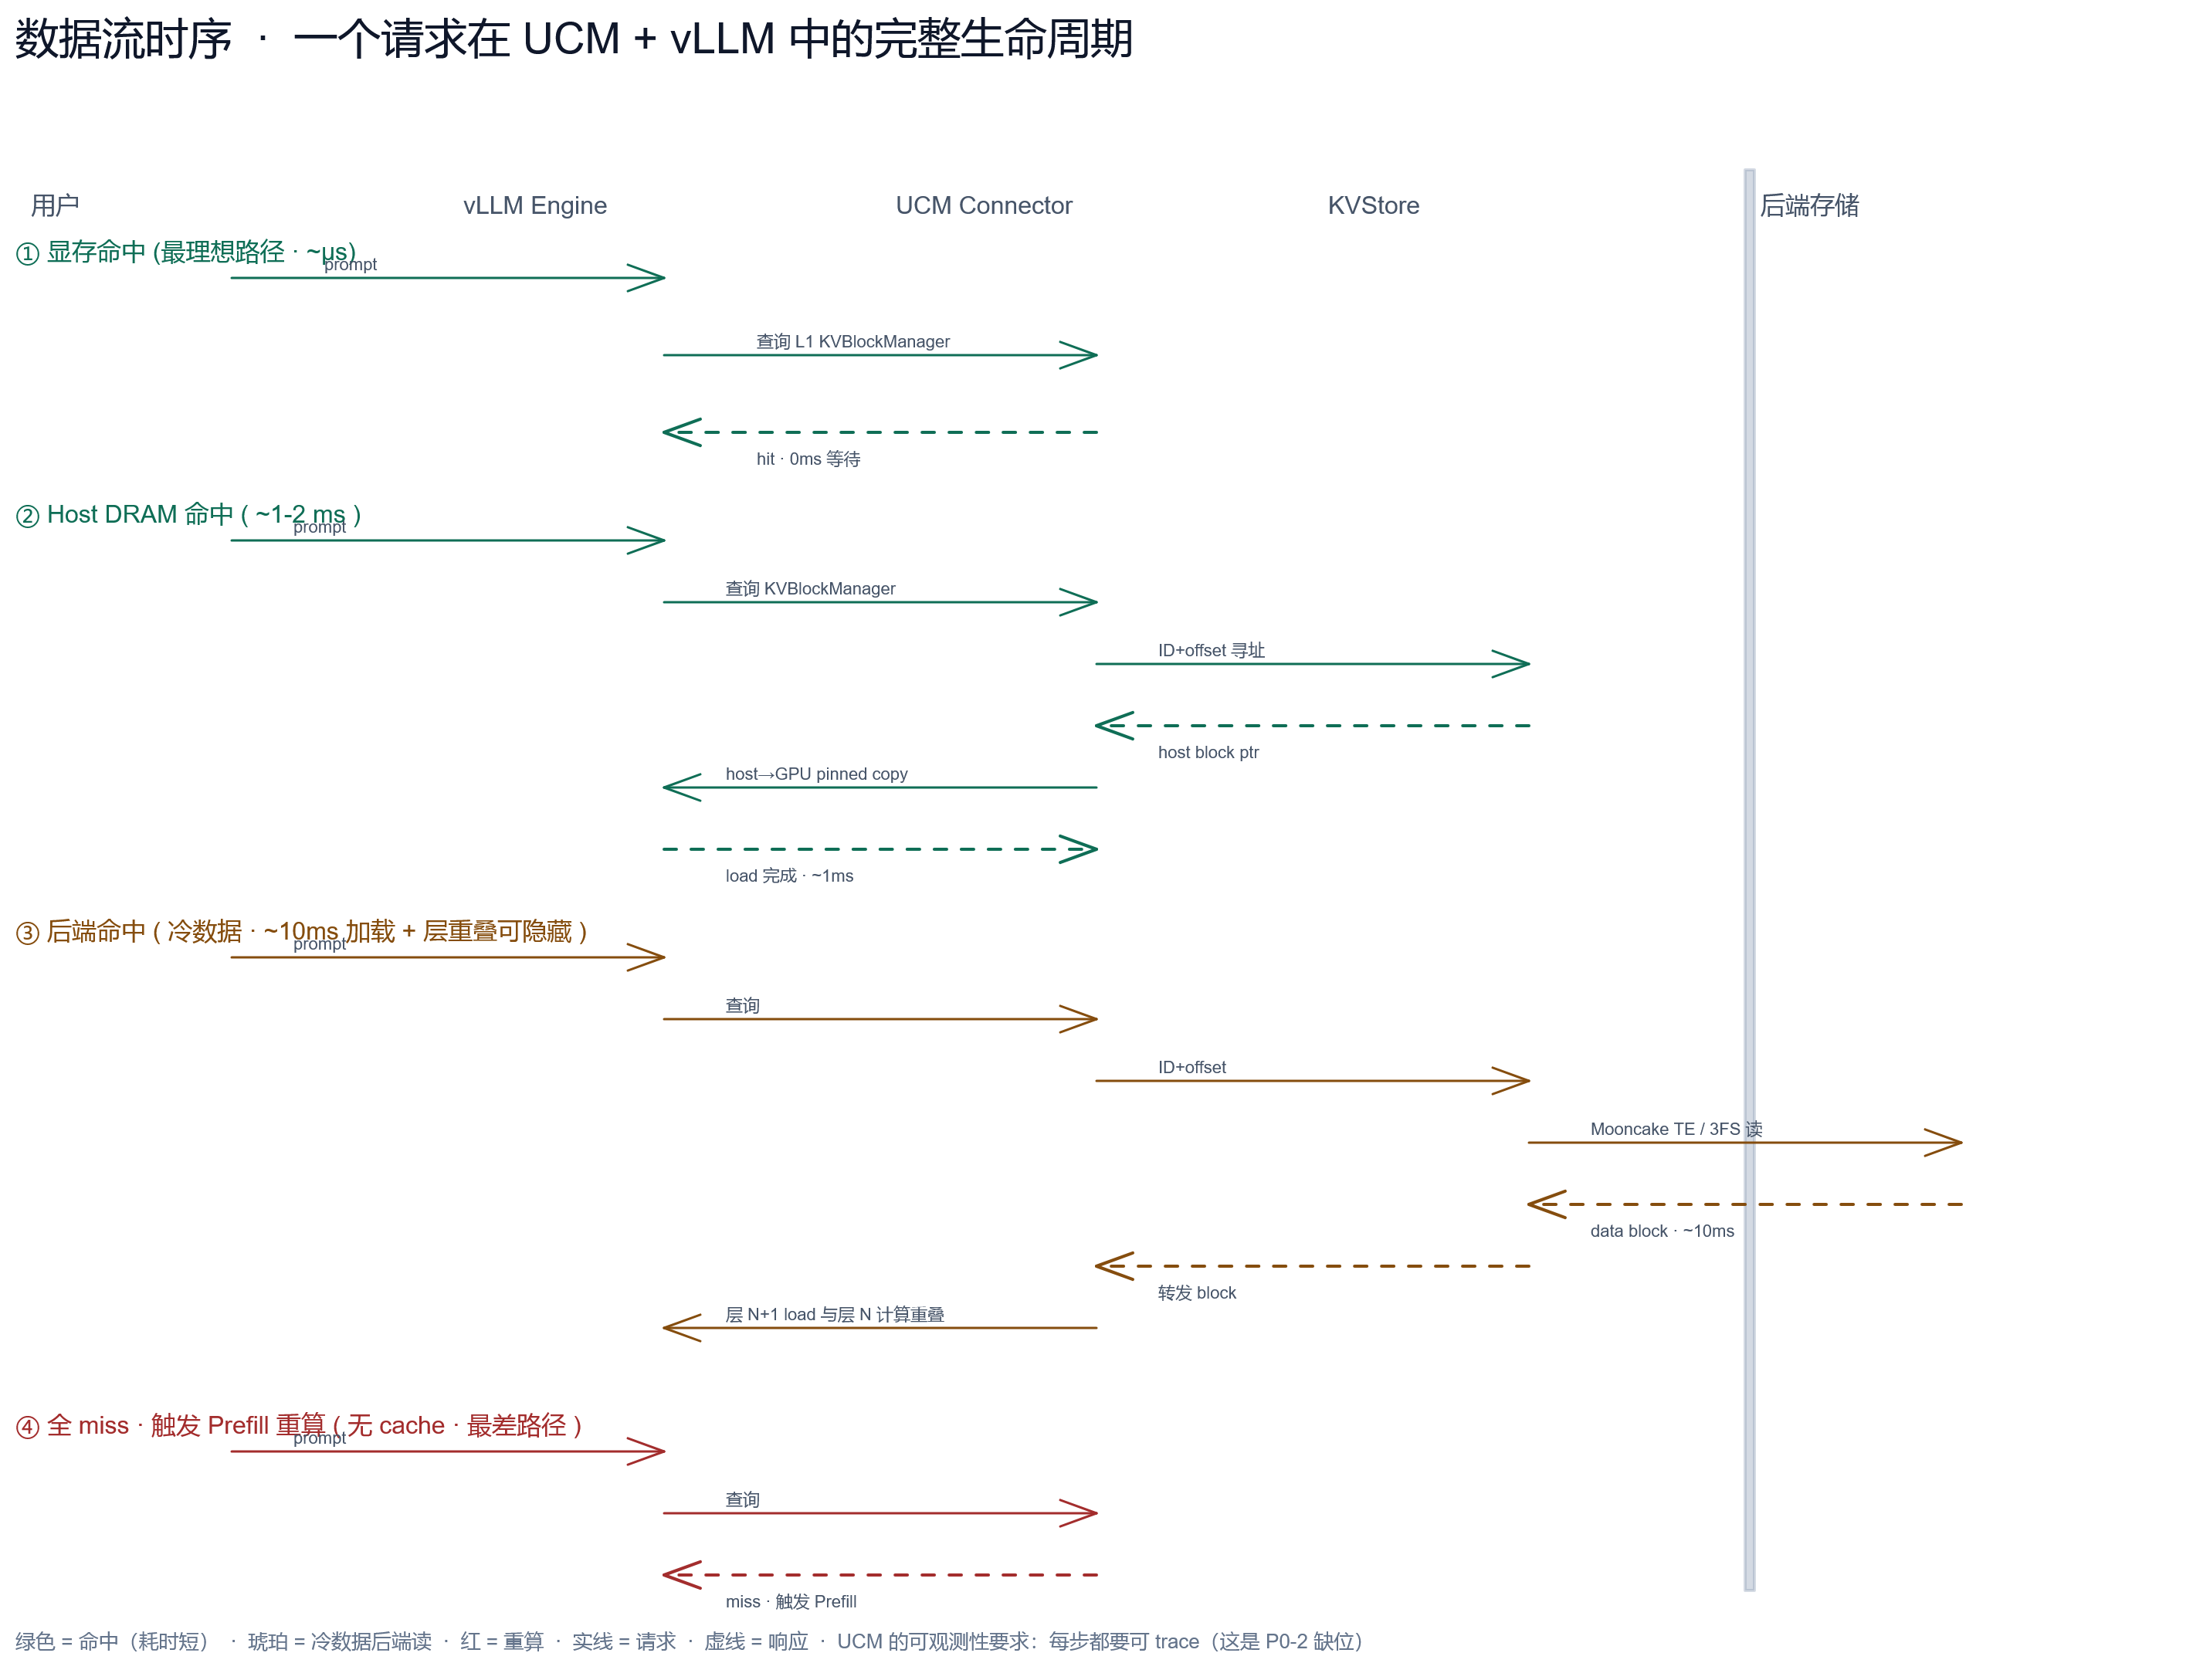
6.1 Block / Page 粒度与寻址
| 方案 | 最小寻址单元 | chunk 粒度 | 备注 |
|---|---|---|---|
| vLLM PagedAttention | block(默认 16 token) | 同左 | 行业事实标准 Block 大小 |
| LMCache | chunk(默认 256 token) | 256 | chunking strategy & hashing scheme 可配 |
| HiCache | page | --page-size 可配 |
匹配 GPU 页时按 page 粒度提升访存效率 |
| TairKV | Block | Instance 初始化时指定 | 定长连续 token,有前缀依赖 |
| FlexKV | block(可 block-wise 合并多层) | 同左 | block-wise 模式把多层 KV 合并成大块 I/O |
| UCM | block + offset | 无强制 | UcmKVStoreBase 用 ID + offset 寻址(天然兼容稀疏与前缀) |
| Dynamo KVBM | block(page_size) | LayoutConfig 决定 | block 句柄支持 mutable / immutable,含优先级 metadata |
粒度越小,缓存粒度越细但元数据压力越大;粒度越大,命中率波动越大但管理开销小。UCM 的 ID + offset 是最抽象的形式——理论上可以做到 token 级稀疏,但实际工程上以 block 为主。
6.2 内存布局:layer_first vs page_first vs page_first_direct
这是 HiCache 唯一做实、但其他家都需要面对的关键 I/O 优化点。GPU 内部按层执行 attention(layer-first 布局与计算内核天然兼容),但 I/O 想要的是连续大块(page-first 布局以优化 I/O 效率)。
| 布局 | 优点 | 代价 | 谁在做 |
|---|---|---|---|
| layer_first | 与 GPU 计算内核天然兼容,零拷贝到 GPU | 层间不连续,I/O 粒度小 | 默认;UCM、Dynamo、Mooncake |
| page_first | 同一 Page 的所有 KV 连续,单次 I/O 粒度大 | 加载到 GPU 时需按“每层一个 token”拆分 | HiCache(默认)、LMCache(chunk 内连续) |
| page_first_direct | page_first 基础上层内聚合,按 Page-Layer 批量传输 | 实现复杂度高 | HiCache(可配) |
对 UCM 的含义:UCM 的 GPU 内部是 layer_first 布局(与 vLLM 一致),但 Host 侧存储可以由 CacheStore 决定用哪种布局。Delegator(2026-08)做的“设备内存内对齐”实际上是在补 layer_first → page_first 之间的转换层。
6.3 传输路径与零拷贝
| 机制 | 作用 | 谁在做 | 带宽量级 |
|---|---|---|---|
cudaMemcpyAsync 基线 |
主机-设备同步/异步拷贝 | 所有人 | ~30 GB/s(PCIe Gen4) |
| GPU-assisted I/O kernel | 专为 KVCache 模式优化的 I/O 内核 | HiCache(最高 3× vs cudaMemcpyAsync) | ~80-100 GB/s |
| GDS(GPU Direct Storage) | 绕过 CPU 直接 SSD→GPU | FlexKV、Dynamo KVBM、LMCache | ~10-20 GB/s(NVMe) |
| GDR(GPU Direct RDMA) | 绕过 CPU 直接 GPU↔远程 | Mooncake TE、UCM dev-sandbox | 87 GB/s(4×200G)/ 190 GB/s(8×400G) |
| NVLink C2C | CPU-GPU 全互联 | Grace Hopper | TB/s 级 |
| 内存语义(MemCache / MemFabric) | GVA 统一编址,memcpy 语义跨机 |
昇腾 A3 | 102~155 GB/s(实测) |
关键判断:内存语义 vs 消息语义是 L0 层的关键分野。Mooncake TE / NIXL 是消息语义(要走 control plane 消息);MemCache 是内存语义(memcpy 直写)。在昇腾 A3 实测中,内存语义方案的时延随规模线性增长且明显更低。UCM 在昇腾上应该把这条优势打出来——ucm/sparse/gsa_on_device 名字里就暗示了在 NPU 设备内存上做稀疏化,配合 MemCache 的内存语义能极大压缩数据搬运量。
6.4 计算-传输重叠(pipeline overlap)
| 方案 | 重叠策略 | 效果 |
|---|---|---|
| HiCache | 层 N+1 KV 加载 ↔ 层 N attention 计算 | 加载延迟可被完全隐藏,前提是 L2 命中 |
| LMCache | 异步 offloading,不阻塞推理线程 | 推理主链路不受存储延迟影响 |
| FlexKV | 异步流水线 Store/Retrieve 与 GPU 计算重叠 | 同上,更精细 |
| UCM | Delegator 异步 executor + copy stream;Ascend FFTS SDMA 聚合小片段 | DeepSeek V4 FA 场景 TTFT 降 15.8%~21.6% |
| Dynamo | TransferManager 异步队列(per-path queues: D→H, H→D, H→Dsk, Dsk→D) | 支持优先级调度与批量合并 |
6.5 预取与回写策略矩阵
| 方案 | 预取策略 | 回写策略 | 可调参数 |
|---|---|---|---|
| HiCache | best_effort / wait_complete / timeout(timeout = base 2s + 0.1s/千 token, cap 30s) | write_through / write_through_selective / write_back | --hicache-storage-prefetch-policy 等 |
| Dynamo | 由复用频率驱动迁移(opportunistic) | DISK_OFFLOAD_FILTER 默认开启 |
HOST_OFFLOAD_PREFIX_MIN_PRIORITY |
| LMCache | 异步,per-chunk prefetch | LRU + pin/unpin 防驱逐 | Controller API |
| FlexKV | 异步 | 水位淘汰(85% 水位,触发后淘汰 5%) | 无明显可调 |
| UCM | DramPool TTL/绝对位置/LRU | 同上 | 无明显可调(公开材料) |
| Mooncake | Conductor 预测式早期拒绝 + 推测调度 | 多副本 + 引用计数 | SLO 目标驱动 |
6.6 淘汰与多进程一致性
多进程场景下的关键工程问题:TP/PP 模式下不同 rank 同时读写同一 block 的不同 head/部分,生命周期绑定、缺一不可。
- HiCache(MLA 单 rank 回写):MLA 模型下不同 rank 持有完整且相同的 KV 数据,HiCache 仅让一个 rank 执行回写,避免跨 rank 冗余存储。MHA 模型下不同 rank 持有 KV 不同分片,因此需要独立回写。
- HiCache(TP 下 all_reduce 同步):预取阶段用
all_reduce(op=min)确保所有 rank 获得相同的 L3 命中数量;预取完成后再次 all_reduce 确保各 rank 对成功获取的 KV 前缀长度达成一致。 - TairKV(Block/CacheLocation 状态机):从根本上解决“部分写入不可读”问题——CacheLocation 在
writing状态时不可被读,deleting时延迟清理。 - UCM(缺位):公开材料里没看到任何跨 rank 一致性设计。理论上走 vLLM 自身的 all_reduce 即可,但落到 UCM 自家
UcmSparseBase的自定义算法里时,这层一致性责任是模糊的。
7. 控制平面细节:元数据组织、KV 感知路由、淘汰一致性
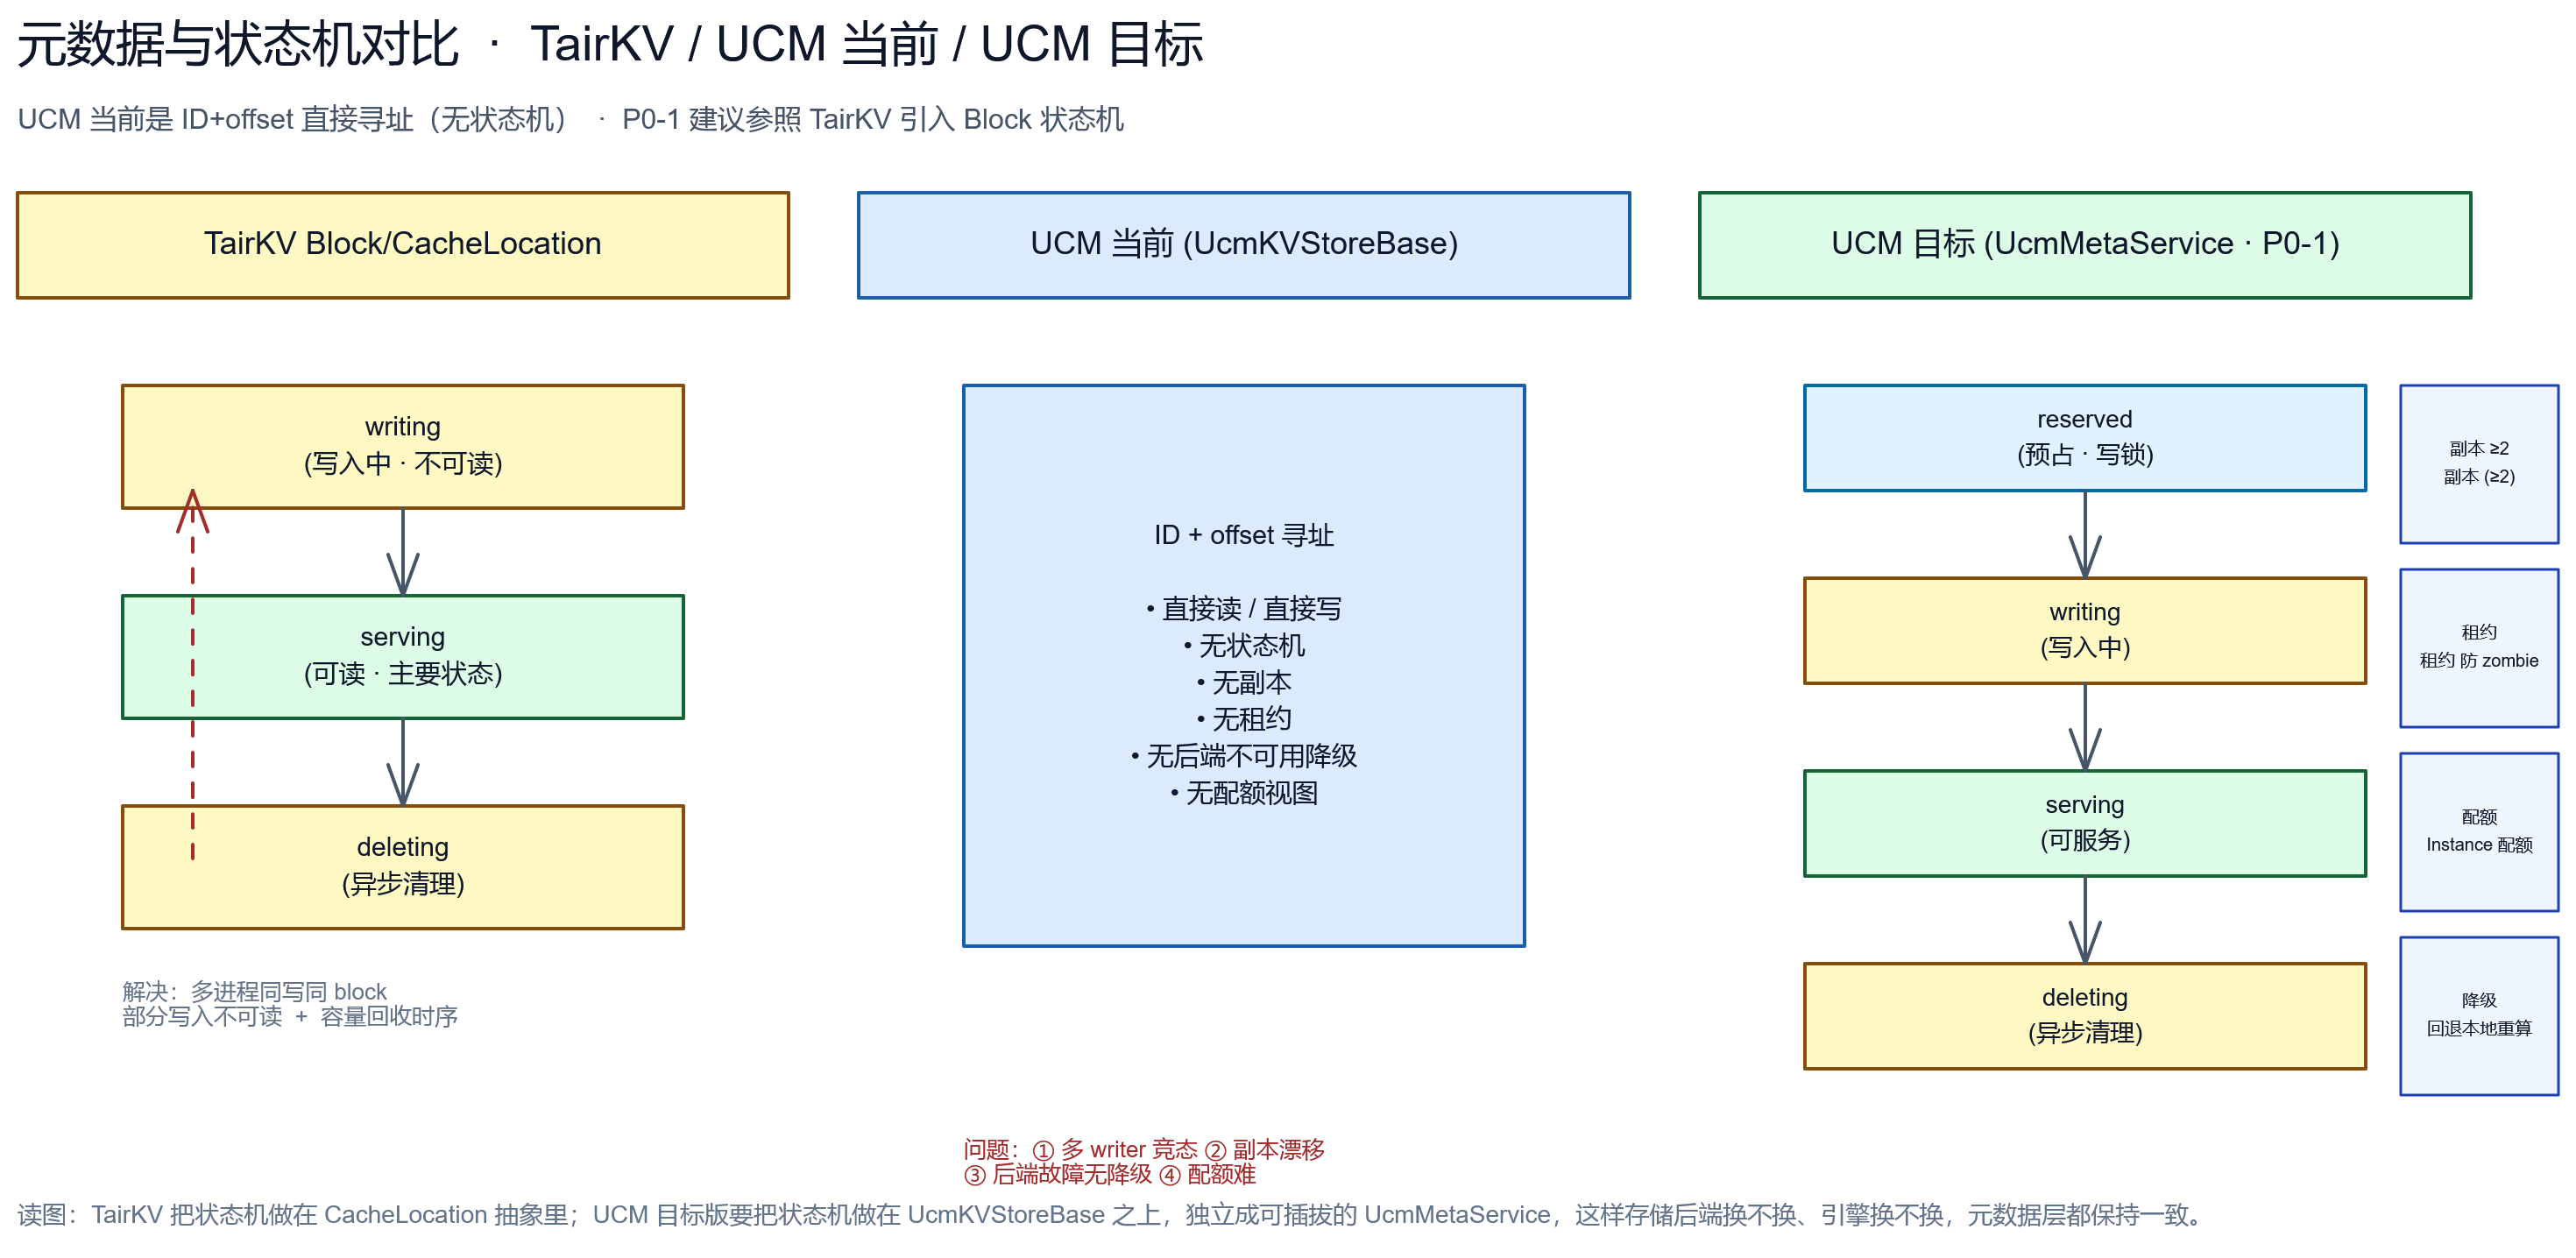
7.1 元数据组织方式对比
| 方案 | 元数据结构 | L3 元数据本地缓存? | 跨实例元数据? |
|---|---|---|---|
| SGLang RadixAttention | RadixTree(每节点 = 一段 token 的 KV) | — | 无(单实例) |
| HiCache | HiRadixTree(节点记录 L1/L2/L3 多层位置) | 不缓存,访问 L3 实时查后端 | 无(依赖 L3 后端做跨实例) |
| LMCache | Token Database hash(chunk_id → KV entry + location) | — | MP 模式靠 controller 协调 |
| FlexKV | 分布式 RadixTree(去中心化) | 是,每节点一份,通过 lease 协调 | 是(避免单点) |
| TairKV | 中心化元数据(Block/CacheLocation) | — | 是(单点由 etcd 类底座保证) |
| UCM | ID + offset(KVStoreBase 视角) | — | 无(每实例独立) |
HiCache 为什么不缓存 L3 元数据?因为 L3 元数据变更频繁(其他实例可能在写),本地缓存会失效。直接查后端虽然有 RPC 开销,但避免了缓存一致性问题——这是它和 Mooncake Store / 3FS 协作的契约设计。
7.2 KV 感知路由(KV-aware routing)
这是决定集群级缓存命中率的关键——打散请求到不同实例上,跨实例缓存就完全失效。
| 方案 | 实现 | 路由粒度 | 可演进性 |
|---|---|---|---|
| NVIDIA Dynamo | KV-aware router(全局) | prefix hash | 高(与 GPU Planner 联动) |
| FlexKV | 本地缓存摘要 ZMQ 实时上报 Dynamo Router | prefix 摘要 | 中(依赖外部路由) |
| Mooncake Conductor | 预测式早期拒绝 + 全局调度(开源度低) | 请求级 | 中(Kimi 业务耦合) |
| LMCache | 依赖上层引擎的调度 | — | 低(自定位为引擎外挂层) |
| UCM | 无 | — | 空白 |
P1 · 关键技术点|FlexKV 的“轻量版”路由方案
FlexKV 没有自建路由器,而是把本地缓存摘要(如“我这个 instance 有 prefix hash X”)通过 ZMQ 事件实时上报给 Dynamo 的 KV Router,路由器基于全局 RadixTree 视图把请求调度到命中率最高的 Worker。UCM 可以借鉴这个思路——不自研路由层,接入 Dynamo / llm-d 等现有方案即可。这是 P1-2 建议的来源。
8. 算法层:UCM 稀疏算法族的工程实装
这是 UCM 真正的护城河——也是其他所有方案都没有的能力层。
8.1 6 个已落地稀疏算法对照
| 算法 | 类型 | 核心思想 | 适用场景 | 训练需求 |
|---|---|---|---|---|
| GSA(Geometric Sparse Attention) | 几何稀疏 | 最大范数 + SVD 联合 Block 表征 → 块级几何表征 + 稀疏卸载与预取 + 自适应稀疏/稠密切换 | 超长序列、显存紧张 | 无需 |
| GSA on Device | GSA 变种 | 把 GSA 的稀疏化放在 NPU/GPU 设备内存上做,配合 MemCache 内存语义 | 昇腾超节点 | 无需 |
| ESA(Early Sparse Attention) | 早退稀疏 | 浅层评估 token 重要性,深层按重要性过滤 | 通用长文本 | 无需 |
| KVStar | query-driven 算前筛选 | 用 query 探测关键 KV,避免完整 QK 内积 | 推理 FLOPs 受限 | 无需 |
| CacheBlend | 非前缀复用 | 把多个不连续前缀的 KV 拼接为完整输入,token 级别 scatter 回 GPU | RAG、多文档拼装 | 无需 |
| Rerope(Model Window Extrapolation) | 窗口外推 | 模型训练窗口外的长上下文处理,位置编码重映射 | 训练窗口 4K、推理 32K+ | 无需 |
8.2 自适应渐进式重算(解决 RoPE 位置编码偏差)
当拼接新输入导致 RoPE 位置编码偏差时,朴素做法是全部重算或全部重用——都不理想。UCM 的做法是分 Transformer 层采用不同重算力度:
- 浅层(Shallow Layers):重算比例高(甚至 100%)。浅层网络学位置和语法等基础特征,位置偏差影响最大,必须在“源头”彻底修复。
- 深层(Deep Layers):重算比例递减,仅对差异超过设定阈值的 token 进行补算。深层网络更关注抽象语义关系,对精确位置不敏感。
本质上是计算资源的最优化分配,把算力集中于对结果影响最大的浅层网络。 中置信(基于华为官方解读)
8.3 三类稀疏的演进
从公开材料看,UCM 把稀疏算法演进划成 4 阶段:
- IO/内存优化(奠基):FlashAttention、xFormers fusion——Dense 计算但减少 HBM↔SRAM 数据访问。不减 FLOPs,只减 IO。
- KV Cache 结构稀疏(早期工程):vLLM PagedAttention、Sliding Window KV、压缩/量化——只关注 K/V 存储。
- Attention 算后稀疏:Top-K、Attention Score 阈值——算后裁剪,FLOPs 已付出。
- Query 驱动算前稀疏(UCM 重点):QUEST、低秩 query 探测、基于能量的预选择——FLOPs 级别真正减法。
UCM 的 GSA 属于“算前稀疏”+“结构稀疏”的混合体——块级几何表征(结构)+ 范数+SVD 联合 Block 表征(query 探测思想)——是更进化的形态。
9. 硬件与异构适配:Ascend/CUDA、MLA/MHA、混合架构
9.1 平台适配现状
| 方案 | CUDA | Ascend | 其它 | GDS | GDR | HIXL |
|---|---|---|---|---|---|---|
| UCM | ● | ●(A2/A3) | Simulation | ●(libibverbs) | ● | ●(多 HIXL 设备) |
| Mooncake | ● | — | — | ●(GPUDirect RDMA) | ● | — |
| HiCache | ● | — | — | — | — | — |
| LMCache | ● | — | AMD MI300X | ●(NIXL) | — | — |
| Dynamo | ●(独占) | — | — | ●(NIXL + Vast 测试 35 GB/s) | ● | — |
| FlexKV | ● | — | — | ● | ●(Mooncake TE) | — |
| TairKV | ● | — | — | — | — | — |
| MemCache | — | ●(昇腾 A3 独家) | 鲲鹏 | — | — | — |
UCM 是唯一同时支持 CUDA 与 Ascend 的方案——这是它的硬件平台护城河。但 CUDA 侧的“用户基础”远不如昇腾深,MindCluster / MemCache + UCM + vLLM-Ascend 这套是昇腾事实标准。
9.2 MLA vs MHA 的 KV 分布差异
DeepSeek 系列模型使用 MLA(Multi-Layer Attention)而非传统 MHA(Multi-Head Attention),KV 分布完全不同:
- MHA:每个 token 的 KV 数据被切成
1/tp_size份,各 rank 持有不同分片——回写时各 rank 独立回写。 - MLA:每个 token 的完整且相同的 KV 数据被各 rank 同时持有——若所有 rank 都回写就产生冗余存储。HiCache 优化:仅一个 rank 执行回写。
UCM 的 FAWA Connector(UCMFAWAConnector)处理 DeepSeek V4 的 Full Attention / Window Attention 双路径,分别用不同的 cache_io_aggregation 配置——这是 2026 年最前沿的异构 KV 适配。
9.3 混合架构(Mamba-Transformer)与异构 KV group
DeepSeek V4 引入了异构 C4/C128/indexer KV group + FullKV + SWA 双缓存 + attention/indexer compress-state sidecar——这种混合注意力架构对 KVCache 卸载系统提出了新挑战:
- 不同层的 KV shape 不同(linear attention 的 compress state vs full attention 的 KV)
- SWA(Sliding Window Attention)的反向滑动窗口查询模式需要特殊处理
- indexer 是单独的状态,需要独立的元数据
FlexKV 在 2026-07 完成了 DeepSeek-V4 适配(逐层恢复、异构 KV group、compress-state sidecar);UCM 的 FAWA Connector 是类似路径但深度可能不及 FlexKV 公开材料细致。
10. 可观测性技术细节
10.1 指标维度拆解
| 指标 | UCM | LMCache | Dynamo |
|---|---|---|---|
| 分层命中率(GPU/Host/Backend) | 按文档公式可算 | — | — |
| load/dump 带宽 | ●(ucm-toolkit 可测) | ● | ● |
| 命中 p50/p90/p99 延迟 | ●(Grafana 三视图) | ● | ● |
| 请求级 span | ✗(P0-2 缺位) | ●(per-request OTel) | — |
| CacheBlend V3 hit_rate breakdown | — | ●(独立 span 树) | — |
| L1 chunk 生命周期直方图 | — | ●(1% 采样) | — |
| 存储 backend/wait 细分 | ●(PR #1281) | — | — |
| 网络监控(NIC) | ●(nic-monitor 独家) | — | — |
| 微基准(IO 路径) | ●(dev-sandbox 22 用例独家) | — | — |
10.2 LMCache 的 OTel span 模型(参考)
LMCache 已经为 OTel tracing 树立了行业参考:
request [══════════════════════════════════════] hit_rate=0.75 ├─ mp.lookup_prefetch [════] (查 L1+L2 缓存) ├─ mp.retrieve [════════] (从 L2→L1 加载) └─ mp.store [══════] (新生成的 KV 回写)
CacheBlend (blend server) 路径: cb.request ├─ cb.lookup (attr prefix_chunks) ├─ cb.fingerprint_match (match probe hashes) ├─ cb.sparse_prefetch (非前缀 shifted chunks) └─ cb.scatter (token-scatter GPU step)每个 span 携带的属性:hit_tokens(int)、requested_tokens(int)、hit_rate(float)。高置信
10.3 UCM 推荐 tracing span 模型
参照 LMCache + HiCache 实践,UCM 的 span 模型应该突出稀疏化这一独占能力:
request [═══════════════════════════════════] hit_rate=0.75 ├─ ucm.lookup (L1 KVBlockManager 查询) ├─ ucm.load (Host→GPU 加载) ├─ ucm.sparse_calc (UcmSparseBase 关键决策点 · UCM 独占) │ ├─ ucm.sparse.gsa (几何稀疏) │ └─ ucm.sparse.esa (Early Sparse) ├─ ucm.compute (实际 attention 计算) └─ ucm.dump (回写 Host + 远端)把 ucm.sparse_calc 单独拆出来是 UCM 区别于其他方案的差异化价值点——必须让用户在 trace 里能看到“这次请求走了哪种稀疏算法、节省了多少 FLOPs”。
10.4 决策类可观测:TairKV HiSim
TairKV 配套的 HiSim 仿真器是“决策可观测”的代表:
- 普通 CPU 服务器即可预测端到端推理性能;
- 联合 NVIDIA Dynamo AIConfigurator 在“时延-吞吐-成本”三角约束下自动搜索最优配置;
- 宣称 39 万倍成本优势(vs 真实部署测试)。
UCM 的 ucm-toolkit 偏“测量”不偏“决策”——P1-3 建议补一个容量-命中率-成本仿真器,复用 dev-sandbox 的微基准做校准。
11. 性能数字的工程解读
11.1 “以存代算”的临界点
KVCache 卸载的合理性来自一个简单事实:从存储介质加载 KV 的端到端延迟,在序列长度超过某个阈值后反而低于 GPU 重算。
以 Qwen2-7B 模型为例,在千级 QPS、平均 1K 输入的在线服务场景下,叠加多轮对话的状态保持、Prefix Caching 等需求,KVCache 总量随缓存时长呈线性增长——从秒级的 GB 量级迅速膨胀至天级的 PB 量级,远超本地显存乃至主机内存的承载上限。—— 阿里云 Tair KVCache 团队
11.2 带宽需求计算
阿里 Tair 给出的关键数字:20GB/s 跨机带宽即可满足主流模型的 KV 跨机传输需求。
- DeepSeek-R1 Prefill 吞吐:32.2K tokens/s(官方披露)
- Qwen3-Coder Prefill 吞吐(优化部署):~10000 tokens/s(阿里实测)
- EGS 8 卡机型:20GB/s 通用网络带宽
- 灵骏 8 卡机型:25GB/s 存储带宽(另有 200-400GB/s ScaleOut 网络)
含义:在大多数推理场景中,KV 跨机传输不是瓶颈。瓶颈在调度和命中率——这也解释了为什么 TairKV 把管理面做厚、Dynamo 把 KV 路由做厚。
11.3 KV Cache 容量估算
Llama3-70B 处理 128K token 输入:KV Cache ≈ 40 GB,TTFT ≈ 19 秒(4×H100 平台,IBM 实测)。
含义:单卡 H100(80GB)放不下完整 KVCache,必须卸载。这就是 UCM Prefill Offload 与 Dynamo G2/G3 的现实驱动力。
11.4 UCM 官方数字的解读
| 指标 | 数字 | 解读 |
|---|---|---|
| 首 Token 时延最高降 | 90% | 最理想场景(全前缀命中 + 长上下文)。基线没说清,可能在最有利场景下测的。 |
| TPS 提升 | 2-22× | 2× 是典型增益,22× 应该是特定极端场景的峰值。 |
| 上下文窗口扩展 | 10×级 | 相对单卡,10× 是合理范围。 |
| 中国银联“客户之声” | 125× | 单点案例,可信度待考。 |
| Ascend IO 聚合 (DeepSeek V4 FA) | TTFT -15.8% ~ -21.6% | 唯一可复现的数字(PR #1038 给出基线、输入长度、并发、命中率) |
P1 · 解读|为什么 UCM 的“22ד看起来比对手更夸张
对比:HiCache 6×(LMSYS blog)、FlexKV 0.6-0.7×(TTFT/TPOT 微增益)、Dynamo 56×(IBM Redbook,130K token + 缓存持久化场景)。
UCM 22× 的口径可能是“纯稀疏化”而非“含卸载”——GSA 减掉 90% FLOPs 后吞吐可能确实到这个量级。但和“卸载”的 TPS 提升是不同概念。P1-1 建议必须把“省算”和“省存”两个维度的数字分开展示,否则容易被解读成虚假宣传。
12. UCM 差距清单(P0 / P1 / P2)
排序依据 = 对选型结果的影响强度 × 补齐的可行性。P0 是“不加就会被排除在选型清单外”的项目。
P0-1|补一层全局元数据 / 目录服务(UcmMetaService)
差距:UCM 目前是“引擎插件”而非“集群基础设施”。
KVStoreBase的 ID+offset 是单机视角寻址,没有跨实例的 Block 生命周期状态机,没有副本策略,没有一致性定义。参照:TairKV 的 Block / CacheLocation(writing → serving → deleting)两级抽象 + Storage / InstanceGroup / Instance 三级管控面,是当前最好的参考实现。关键洞察是它不替代底层存储,只做 LLM 语义适配——这与 UCM 的
KVStoreBase定位完全一致,改造成本可控。建议动作:在
KVStoreBase之上加一层可选的元数据服务,先实现三件事——① Block 状态机与租约(解决部分写入不可读);② 按 Instance 维度的容量配额与 LRU 全局视图;③ 后端不可用时的降级开关(回退本地重算)。不追求一次性做齐多租户。验收:3 实例集群下,杀掉任一实例,其余实例缓存命中率下降 < 15% 且不出现脏读。
P0-2|可观测接入 OTel,补齐 request 级 tracing
差距:LMCache 已有 per-request root span(带
hit_rate属性)+mp.lookup_prefetch/mp.retrieve/mp.store子 span + Tempo/Grafana 一键栈;UCM 只有 Prometheus counter/gauge + 自研metrics-view(SQLite + 手搓 PromQL)。线上排障时无法回答“是哪个请求的哪个阶段慢”。建议动作:① 用 OTel SDK 替换自研 metrics 采集,保留
/metrics端点但改用标准导出器;② 为每个请求发 root span,属性至少包含requested_tokens/hit_tokens/hit_rate/store_tier/sparse_algo(UCM 独占);③ 拆出ucm.lookup/ucm.load/ucm.sparse_calc/ucm.dump子 span(最后一项是 UCM 独有的、必须在 trace 里可见的价值点);④ 提供 docker-compose 一键观测栈。注意:不要把
ucm-toolkit砍掉,它该升维——dev-sandbox的微基准能力是全场独一份,应定位为“标准 OTel 管道 + 差异化硬件 IO 诊断”的组合拳。
P0-3|冲刺 SGLang 主干合入 + vLLM 官方 connector 收录 + 评估许可证
差距:FlexKV 在 2026 年 3–7 月完成 vLLM / Dynamo / TRT-LLM / SGLang 四主干合入,Apache-2.0。UCM 仍是“需用户主动来找”的状态,且许可证是 MIT with additional conditions(比 Apache-2.0 更模糊,企业法务会多问一轮)。
建议动作:① SGLang 是最容易突破的口子(社区已接纳 LMCache、FlexKV、Mooncake 三家,接口成熟),优先提 PR;② 争取进 vLLM 官方 KV connector 文档列表;③ 认真评估把许可证换成 Apache-2.0——FlexKV、Mooncake、Dynamo、LMCache 全是 Apache-2.0,“MIT with additional conditions” 在选型对比表里是个不必要的减分项。
P1-1|发布可复现的第三方基准,把“22ד拆成可验证数字
差距:HiCache 有 LMSYS blog + Novita / 蚂蚁实测 + 可跑的 benchmark 脚本;Dynamo 有 IBM-Supermicro-NVIDIA 三方 Redbook(含噪声网络下的保守值 18×);FlexKV 有 Phison 实测;LMCache 有 AMD / Google / CoreWeave 多方报告。UCM 目前只有华为自研口径(TTFT −90%、TPS 2–22×、窗口 10×)和一个 Ascend IO 聚合的 15.8%~21.6% TTFT 表。
问题不在数字大小,在可信度。“吞吐提升 22 倍”没有说明基线是什么、命中率多少、缓存容量多大,评审方无法验证也无法复现。
建议动作:发布 benchmark 套件(场景 × 模型 × 上下文长度 × 命中率 × 缓存容量 × 硬件),每个数字都标注前置条件;主动给出保守值(IBM 那篇 Redbook 最聪明的地方就是主动测了噪声网络下的 18× 并大方写出来,反而更可信);邀请 1–2 家第三方复现。
P1-2|补 KV 感知路由(轻量版)
差距:FlexKV 用 ZMQ 把本地缓存状态实时上报 Dynamo KV Router;Dynamo 自带 KV-aware router;Mooncake 有 Conductor。UCM 有异构 PD 解耦,但没有配套的缓存感知调度——在集群场景下,路由打散会让前缀缓存命中率断崖式下跌,这是阿里 Tair 文章里点名的核心矛盾(“请求量升高 → 迁移增多 → 命中率下降 → Prefill 非线性增长甚至雪崩”)。
建议动作:先做轻量版——暴露本地 RadixTree/Block 摘要给外部路由(参考 FlexKV 的 ZMQ 事件机制),不自建路由器,接入 Dynamo / llm-d 等现有路由层。
P1-3|增加容量-命中率-成本仿真器
差距:TairKV 的 HiSim 联合 Dynamo AIConfigurator,可在普通 CPU 上以极低成本做“时延-吞吐-成本”三角搜索,帮客户在掏钱之前算出收益。这是售前环节杀伤力最大的工具——企业在部署前最想知道的是“我这个业务上了能省多少钱”。
建议动作:复用
ucm-toolkit已有的测量数据做校准,做一个轻量仿真 CLI:输入业务 trace(请求长度分布、前缀复用模式、QPS)+ 硬件配置,输出推荐的分级容量配比与预估命中率/成本收益。
P2-1|讲清楚 UCM × MemCache 的分层叙事
把 MemCache 当竞品打是战略误判。应对外明确:MemFabric 提供 GVA 统一编址 → MemCache 提供内存语义池化 → UCM 提供 KV 语义管理与稀疏算法 → vLLM-Ascend 提供执行,在昇腾超节点上这是一条比 Mooncake 更完整的垂直栈(Mooncake 只有 TE + Store,没有算法层)。建议出一份联合架构白皮书 + 联合基准(已有 MemCache × Mooncake TE 的对比数据,可直接延伸成 MemCache × Mooncake Store 的对比)。
P2-2|把“稀疏化”做成可对比的公开评测
UCM 有 6 个实装稀疏算法(gsa / gsa_on_device / esa / kvstar / blend / rerope),但公开材料只有 GSA 一篇深度解读,且缺少“在同等精度损失下,GSA vs 其他稀疏方法 vs 不稀疏”的对照表。这是护城河,但护城河需要被看见。建议产出一份稀疏算法选型矩阵(精度损失 / 加速比 / 适用模型结构 / 是否需要训练),让客户自己能算出该选哪个。
P2-3|多租户与配额(可延后)
参考 TairKV 的 InstanceGroup 抽象。在 To B 私有化场景是刚需,但优先级低于 P0/P1——先有全局元数据服务(P0-1),多租户是它之上的一层配置。
13. 证据表与置信度
| 信号 / 判断 | 证据来源 | 置信度 | 风险 / 备注 |
|---|---|---|---|
| UCM 是唯一把稀疏化做成插件框架的卸载系统 | GitHub 仓库 ucm/sparse/ 目录实测:gsa、gsa_on_device、esa、kvstar、blend、rerope;README 的 Support Features 列有 Sparse Attention / Sparse Attention Offload |
高 | 各算法的成熟度不一致,仓库未给出逐算法的精度/性能对照 |
| UCM 存储后端覆盖最广(11 种) | ucm/store/ 目录:nfsstore、posix、pcstore、dram、mooncakestore、ds3fs、yuanrongstore、cache、compress、delegator、pipeline |
高 | “目录存在”不等于“生产可用”,各后端成熟度需实测 |
| UCM 缺全局元数据服务与跨实例 HA | 反向证据:仓库无 meta/metadata service 模块;DramPool 的 TTL/LRU 是池内策略;公开文档无副本、降级、一致性设计。正向对照:TairKV 明确以 HA 为设计目标 | 中 | 基于公开材料的反向推断,华为内部可能有未开源的企业版能力 |
| LMCache 可观测性断档第一 | 官方 docs /mp/observability:EventBus 架构、OTel 三件套、per-request root span 带 hit_rate、CacheBlend 独立 span 树、trace-level storage 离线回放、docker-compose 观测栈 |
高 | Tracing 默认关闭,需显式配置 OTLP 端点 |
| FlexKV 生态合入速度反超 UCM | vLLM PR #34328(2026-03-17,v0.17.2 起内置)、SGLang PR #29701(2026-07-07)、Dynamo 与 TRT-LLM 官方主分支(2026-03) | 高 | 合入 ≠ 生产采用率;LMCache 的实际部署量可能仍更大 |
| MemCache 与 UCM 是互补而非竞争 | 华为昇腾官方技术文章(2025-12):MemCache 属 MindCluster,提供分布式内存池化与对象缓存 Put/Get,“可应用于 KVCache 缓存池等多种场景”;实测均基于 vLLM-Ascend | 中 | 两者分属华为不同产品线,实际协同程度未知;对外打包叙事需组织层面确认 |
| Dynamo G1–G3.5 无跨节点 HA | IBM Community 技术博客(2026-06)明确指出“Because G1 through G3.5 architectures are restricted to a single hardware node, they offer no HA protection” | 高 | IBM 有推销 G4 存储层的动机,但陈述本身是架构事实 |
| HiCache 跨实例共享完全依赖 L3 后端 | LMSYS blog(2025-09)+ SGLang 文档:L1/L2 私有、L3 共享;L3 元数据实时查后端、不本地缓存 | 高 | — |
| TairKV 的管理面能力是当前最完整的 | 阿里云开发者社区系列文章第 4 篇(2026):三级管控面抽象、Block/CacheLocation 状态机、多租户/配额/版本协同/ROI/HA 全清单;HiSim 仿真器 | 高 | 深度绑定阿里云商业版;开源版能力边界需核对 |
| UCM 性能数字口径不够可验证 | 官方口径“TTFT 最高降 90%、TPS 提升 2–22×、窗口 10×级、银联 125ד均无基线/命中率/容量说明;仅 PR #1038 给出结构化对照表(15.8%~21.6%) | 高 | 可能已有内部白皮书未公开 |
| Mooncake TE 是事实标准传输层 | 被 NIXL 收为 backend plugin(2025-05);同时是 HiCache L3 后端、LMCache remote connector、TairKV Storage 类型、FlexKV 远端缓存层(2026-07) | 高 | — |
| MIT with additional conditions 是选型减分项 | UCM README 明确声明;对照 FlexKV / Mooncake / Dynamo / LMCache 均为 Apache-2.0 | 中 | 需法务确认 additional conditions 的具体内容才可定论 |
| MemCache 内存语义时延优势 | 昇腾官方实测:单 die 跨机 RD2LD 155 GB/s;对比 Mooncake TE 非内存语义方案,时延随规模线性增长且更低 | 高 | 仅在昇腾 A3 硬件 + 灵衢互联下成立 |
| HiCache MLA 单 rank 回写优化 | SGLang 文档 + LMSYS blog:MLA 下各 rank 持有完整且相同的 KV,仅一个 rank 回写避免冗余 | 高 | — |
| FlexKV block-wise 模式合并多层 KV | FlexKV 官方文档:block-wise 模式可将多个网络层 KV 合并为更大粒度 block,提升 I/O 传输效率 | 高 | — |
14. 7 天 / 30 天 / 90 天执行计划
14.1 7 天(拉齐认知 + 止血)
| 天 | 动作 | 产出 |
|---|---|---|
| D1 | 拉齐赛道分层共识 | 内部对齐“UCM 在 L1 + 算法层,缺 L2/L3”这一定位判断,避免把资源投在纯卸载性能上跟 FlexKV 卷 |
| D2 | 盘家底 | 逐项核对 ucm/store/ 11 个后端、ucm/sparse/ 6 个算法的生产就绪度,输出“能对外承诺”的白名单 |
| D3 | 许可证评估 | 法务评估 MIT-with-conditions 换 Apache-2.0 的可行性与成本 |
| D4–D5 | OTel 接入方案设计 | 确定 span 模型(root + lookup/load/sparse_calc/dump + sparse_algo 属性)、属性清单、采样率;评估对现有 Prometheus 指标的兼容方案 |
| D6 | SGLang 合入可行性评估 | 读 SGLang 已合入的 FlexKV connector PR #29701,估算 UCM 的适配工作量 |
| D7 | 基准口径重构 | 定义 benchmark 矩阵的维度(场景/模型/上下文/命中率/容量/硬件),列出需要补跑的格子 |
14.2 30 天(补齐 P0 + 启动 P1)
| 周 | 目标 | 关键动作与验收 |
|---|---|---|
| W1 | P0-2 tracing 落地 | OTel span 树上线(包含 ucm.sparse_calc 子 span);能在 Grafana/Tempo 里按 hit_rate < 0.5 筛出低命中请求并下钻到稀疏算法选择;提供 docker-compose 观测栈 |
| W2 | P0-3 生态破冰 | SGLang connector PR 提交;vLLM 官方 connector 列表提 issue;许可证结论落地 |
| W2–W3 | P0-1 元数据服务设计 | 输出 UcmMetaService 设计文档:Block 状态机(writing/serving/deleting + reserved)、租约、配额视图、降级开关。评审通过 |
| W3 | P1-1 基准发布 | benchmark 套件 + 首批可复现数据发布(含保守值,含“省算”与“省存”分维度),配套复现脚本与 Docker 镜像 |
| W4 | P0-1 原型 + P2-1 叙事 | UcmMetaService 单副本原型跑通 3 实例故障测试;同步启动 UCM × MemCache 联合架构白皮书 |
14.3 90 天方向
- UcmMetaService 多副本 + 多租户配额上线,对齐 TairKV 的管理面能力;
- KV 感知路由轻量版(暴露缓存摘要给外部路由,不自研路由器);
- 容量-命中率-成本仿真器 CLI(P1-3);
- 稀疏算法选型矩阵发布(P2-2),把 6 个算法的精度/加速/适用面做成可查表;
- UCM × MemCache 联合架构白皮书 + 联合基准发布,对外讲清楚昇腾超节点上的完整栈。
15. 参考来源
- UCM — github.com/ModelEngine-Group/unified-cache-management(README、
ucm/sparse/、ucm/store/目录、PR #518 / #848 / #1012 / #1038 / #1044 / #1241 / #1281 / #1284 / #1300 / #1305,截至 2026-09-02 共 697 commits);ucm.readthedocs.io;华为 UCM 技术发布(2025-08-12 预发布,2025-11-05 开源) - Mooncake — github.com/kvcache-ai/Mooncake;FAST’25 Best Paper《Mooncake: A KVCache-centric Disaggregated Architecture for LLM Serving》;Mooncake x SGLang HiCache System Design
- SGLang HiCache — LMSYS Blog (2025-09-10);SGLang 官方文档 HiCache 章节;阿里云开发者社区《阿里云 Tair 联手 SGLang 共建 HiCache》(2025)
- LMCache — Architecture Overview;Observability(multiprocess);LMCache x NIXL x vLLM V1 (2025-04-11);lmcache.ai
- MemCache / MemFabric — 华为昇腾《昇腾超节点百TB级内存语义池化应用实践》(2025-12-03);《基于 HBM/DRAM 的 KVCache 分级缓存实践》(2026-03-11);gitcode.com/Ascend/memcache、gitcode.com/Ascend/memfabric_hybrid
- NVIDIA Dynamo — KVBM Design;KVBM Configuration Reference;NVIDIA 开发者博客《如何使用 NVIDIA Dynamo 减少 KV 缓存瓶颈》;Dynamo 1.0 GA 2026-03-16
- TairKV — 阿里云开发者社区《Tair KVCache Manager:企业级全局 KVCache 管理服务的架构设计与实现》;Alibaba Cloud Blog (English);github.com/alibaba/tair-kvcache
- FlexKV — github.com/taco-project/FlexKV;腾讯云开发者社区《分布式 KVCache 多级缓存架构 - FlexKV 正式开源》(2025-10-09);《腾讯云 FlexKV 合入全球三大主流大模型推理框架》(2026-04-15);vLLM PR #34328、SGLang PR #29701
- IBM / NVIDIA / Supermicro 联合 Redbook — 《Context Without Limits: A High-Performance KV Cache Platform for Large-Scale AI Inference》(MD260021);IBM Community 技术博客(2026-06-25)
本文档基于公开材料整理,评分为主观加权判断,用于内部技术决策参考。所有数字均标注来源,未标注者为结构性推断(已在第 13 节标记置信度)。涉及竞争对手未公开实现的部分,均基于反向推断,实际能力可能更强。配套技术图(diagrams/01-05)已嵌入本报告。